
Sort, Segment y Sequence Project
Una función de ventana conserva cada fila y agrega un valor calculado sobre filas relacionadas. Para producir una numeración por grupo, el plan necesita ordenar el flujo, reconocer dónde cambia cada grupo y mantener el estado de la secuencia.
Sort, Segment y Sequence Project pueden aparecer juntos para realizar esas tres tareas. Ninguno describe por sí solo toda la función escrita en la consulta.
La consulta define grupos y orden
Esta consulta numera los pedidos dentro de cada estado. PARTITION BY reinicia la numeración cuando cambia Estado; ORDER BY define la secuencia dentro del grupo.
Antes de ejecutar, activa Include Actual Execution Plan con Ctrl+M. Al terminar abre Execution plan y sigue la rama desde Sort hacia Segment y Sequence Project. Si un índice ya entrega el orden requerido, SQL Server puede omitir Sort; por eso conviene comprobar el plan real en lugar de buscar siempre los tres nombres.
SELECT
    p.IdPedido,
    p.Estado,
    p.FechaPedido,
    ROW_NUMBER() OVER
    (
        PARTITION BY p.Estado
        ORDER BY p.FechaPedido, p.IdPedido
    ) AS Posicion
FROM dbo.PedidoLaboratorio AS p
OPTION (MAXDOP 1, RECOMPILE);
Una función de ventana calcula un valor sobre un conjunto relacionado sin reducirlo a una fila por grupo. La partición delimita esos conjuntos; el orden de la ventana indica cómo recorrer cada uno.
Sort: preparar el orden requerido
Sort recibe filas y las entrega ordenadas por una o varias expresiones. En este caso necesita producir el orden compuesto por Estado, FechaPedido e IdPedido.
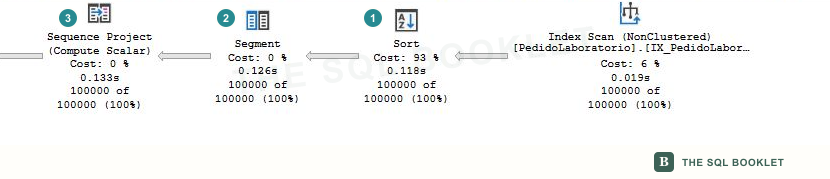
- 1Ordenamiento
Sortorganiza las filas antes de que la secuencia pueda calcularse. - 2Límite de cada partición
Segmentreconoce cuándo cambiaEstadoy marca el inicio del grupo siguiente. - 3Valor de la secuencia
Sequence Projectutiliza esa marca y agrega la posición calculada porROW_NUMBER.
El orden también puede provenir de un índice. Para comprobar si fue necesario producirlo, seguimos la rama de entrada: si no aparece Sort, revisamos Ordered y las llaves del acceso anterior en lugar de asumir que la función dejó de necesitar orden.
Sort suele solicitar una concesión de memoria. Las propiedades Order By, filas observadas, memoria concedida y advertencias indican qué se ordenó y si el trabajo permaneció en memoria.
Segment: marcar el comienzo de cada grupo
Segment compara las columnas de segmentación entre filas consecutivas y marca el inicio de un grupo nuevo. No reúne las filas ni calcula el número: conserva el flujo y agrega la señal que necesita el operador siguiente.
La propiedad Group By muestra las columnas utilizadas para detectar el cambio. En esta consulta, Estado define el límite de cada partición. Si no hubiera PARTITION BY, todas las filas pertenecerían a un solo grupo lógico para la numeración.
La entrada debe llegar en un orden que mantenga juntas las filas del grupo. Por eso Segment se interpreta con el orden producido o conservado por la rama anterior.
Sequence Project: agregar el valor de secuencia
Sequence Project calcula una o varias expresiones que dependen del orden y del estado mantenido mientras avanzan las filas. En este caso produce el valor de ROW_NUMBER.
La propiedad Defined Values permite localizar la columna interna que agrega. El operador recibe la marca de Segment, incrementa la secuencia para cada fila y la reinicia cuando comienza otra partición.
No es una agregación: entrega las mismas filas que recibe, ahora con una columna calculada. Tampoco decide el orden; utiliza el que ya preparó la entrada.
Leer los tres operadores como una cadena
| Paso | Recibe | Produce |
|---|---|---|
Sort |
Filas sin el orden requerido | Filas ordenadas por partición y secuencia |
Segment |
Filas ordenadas | Una marca cuando comienza otro grupo |
Sequence Project |
Filas y marcas de grupo | Las mismas filas con el valor de ventana |
Primero confirmamos las columnas del orden. Después comprobamos qué columna delimita el grupo. Al final identificamos el valor definido por Sequence Project. Esa lectura evita atribuir toda la función al icono más visible.
Qué conclusión todavía no permite obtener
La presencia de estos operadores no demuestra que la consulta esté mal diseñada. El orden y la numeración pueden ser indispensables para el resultado. Un índice diferente podría evitar un Sort, pero también agregar almacenamiento y costo de escritura.
Para evaluar el impacto necesitamos filas, memoria, posibles derrames, frecuencia de ejecución y alternativas que conserven el mismo resultado.
Siguiente comprobación razonable
Continúa con Stream Aggregate y Hash Match (Aggregate) para distinguir dos mecanismos que sí convierten varias filas en un resultado por grupo.