
Análisis guiado de una consulta empresarial reproducible
Una optimización termina cuando podemos explicar qué necesitaba el negocio, qué trabajo hacía SQL Server, qué cambió y qué falta comprobar. Este caso recorre el proceso completo sin atribuir a una sola ejecución más de lo que demuestra.
Definir el resultado antes de mirar el plan
Necesitamos el pedido más reciente en estado Confirmado o Enviado para cada cliente entre 1 y 500. El resultado debe incluir cliente, pedido, fecha, estado y total.
“Más reciente” requiere un desempate. La fecha se ordena de mayor a menor y, si dos pedidos comparten la misma fecha, se conserva el IdPedido mayor. Ese segundo criterio hace determinista la selección: con los mismos datos, la consulta elige la misma fila.
La consulta recibida separa primero los clientes y busca un pedido para cada uno:
DECLARE @ClienteHasta int = 500;

WITH Clientes AS
(
    SELECT DISTINCT p.IdCliente
    FROM dbo.PedidoLaboratorio AS p
    WHERE p.IdCliente BETWEEN 1 AND @ClienteHasta
)
SELECT
    c.IdCliente,
    ult.IdPedido,
    ult.FechaPedido,
    ult.Estado,
    ult.Total
FROM Clientes AS c
CROSS APPLY
(
    SELECT TOP (1)
        p.IdPedido,
        p.FechaPedido,
        p.Estado,
        p.Total
    FROM dbo.PedidoLaboratorio AS p
    WHERE p.IdCliente = c.IdCliente
      AND p.Estado IN ('Confirmado', 'Enviado')
    ORDER BY p.FechaPedido DESC, p.IdPedido DESC
) AS ult
ORDER BY c.IdCliente
OPTION (RECOMPILE);
CROSS APPLY permite que la consulta derecha use el cliente de la fila izquierda. TOP (1) conserva el primer pedido según el orden indicado. Juntas, ambas partes expresan correctamente el contrato; todavía no sabemos cuánto trabajo exige cumplirlo.
Conservar una línea base
La línea base reúne resultado, lecturas, tiempos y plan bajo una misma ejecución. No se sustituye por la impresión de que la consulta “se siente lenta”.
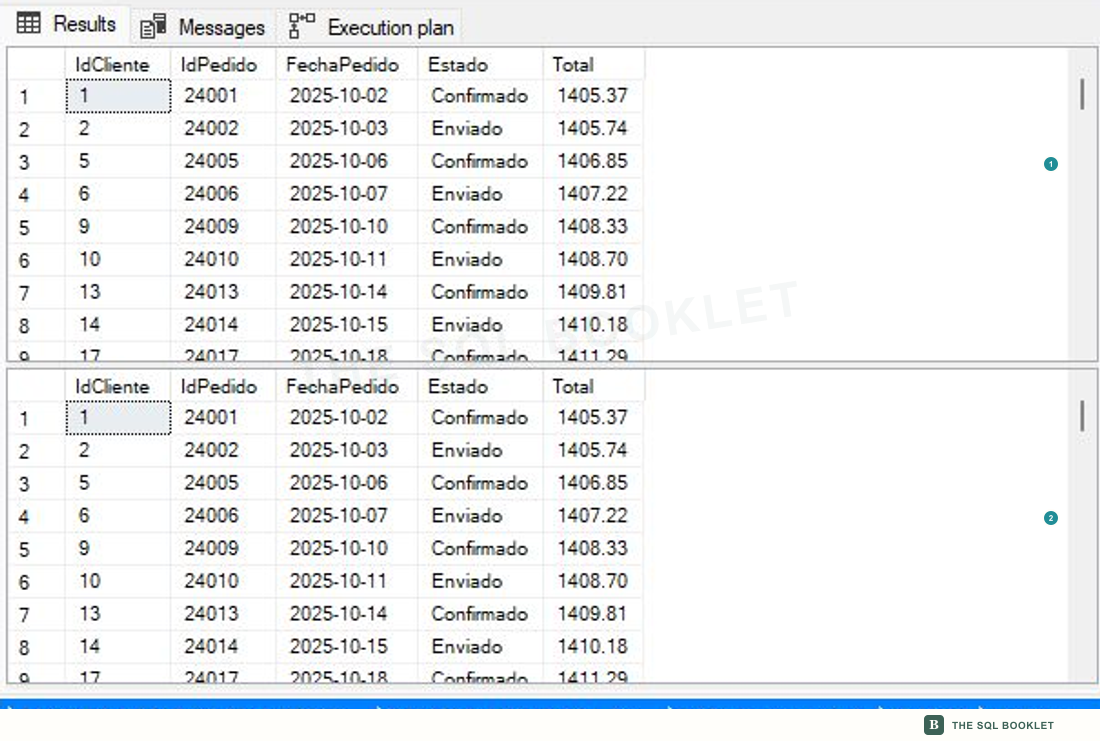
- 1Consulta original
La primera cuadrícula conserva una fila por cliente con pedido relevante.
- 2Alternativa
La segunda cuadrícula comienza con las mismas filas y columnas; la equivalencia completa se comprueba aparte.
Una muestra ayuda a reconocer el resultado, pero no prueba que las 250 filas coincidan. La comparación exhaustiva vendrá antes de aceptar el cambio.
Medir antes de explicar
La consulta original registró actividad en la tabla y en una estructura de trabajo:
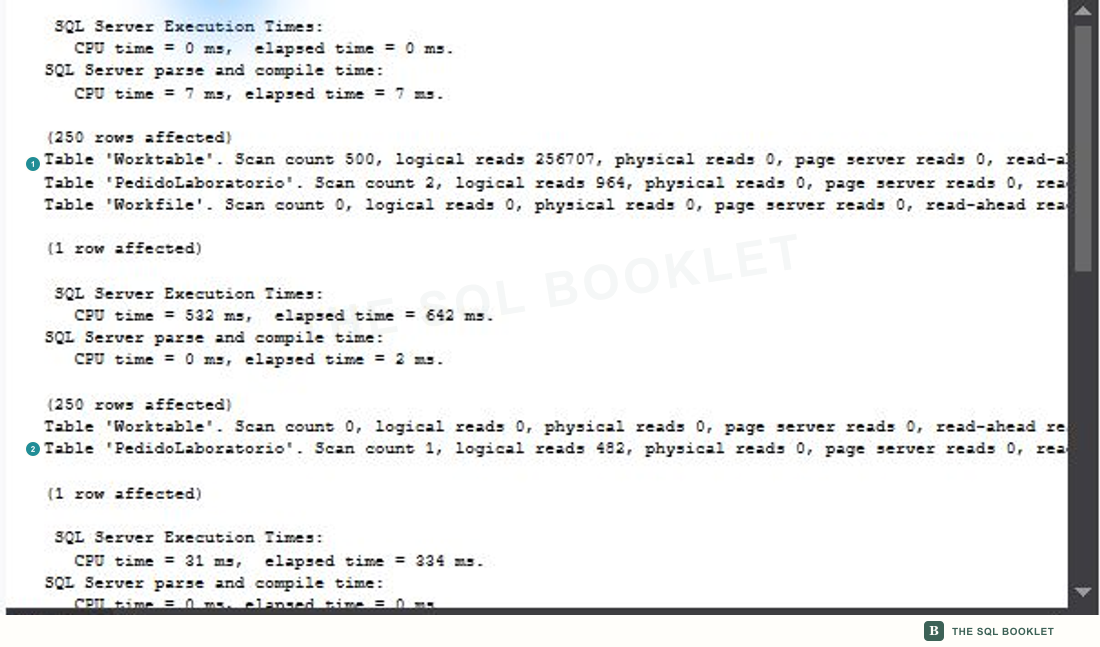
- 1Consulta original
Worktableregistra 500 exploraciones y 256,707 lecturas lógicas; la tabla registra 964 lecturas. - 2Alternativa
Worktablequeda en cero y la tabla registra 482 lecturas lógicas.
Worktable es una estructura interna que SQL Server utiliza para trabajo temporal durante la ejecución. No es una tabla del modelo que debamos consultar o eliminar. Su actividad indica que el plan necesitó materializar o reorganizar información fuera de las estructuras permanentes.
En esta ejecución, la original consumió 532 ms de CPU y 642 ms de duración; la alternativa, 31 ms y 334 ms. Estos tiempos pertenecen al equipo y al momento de la prueba. Las lecturas y el trabajo temporal son evidencia más estable para formular la explicación, pero también deben repetirse con parámetros representativos.
Leer la estrategia original
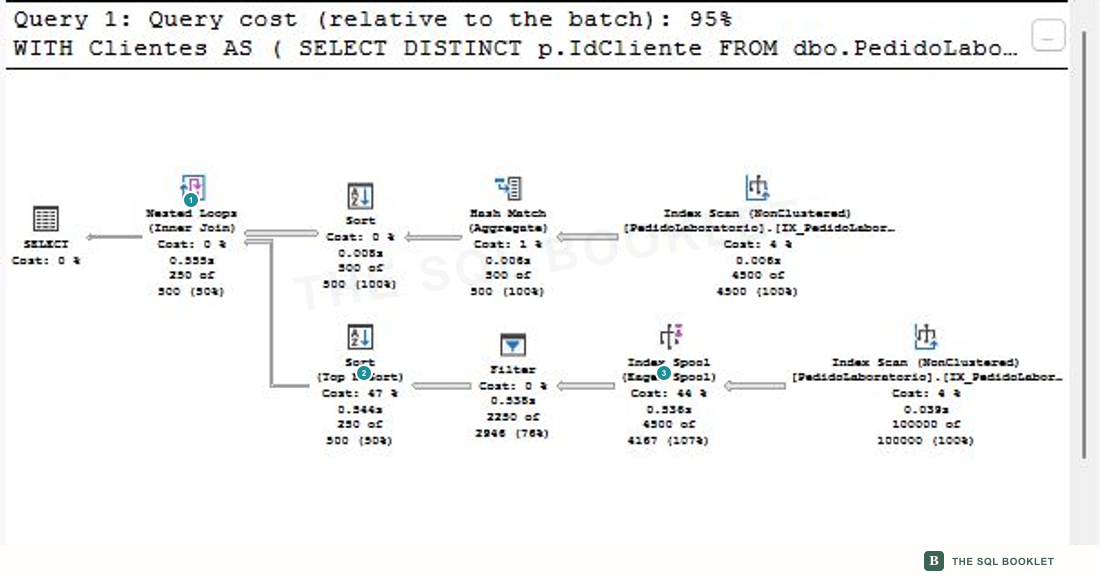
- 1Nested Loops
Coordina una entrada exterior de clientes con una búsqueda interior para cada fila recibida.
- 2Top N Sort
Organiza candidatos para que
TOP (1)conserve el pedido más reciente. - 3Index Spool
Guarda temporalmente filas en una estructura indexada que la rama interior puede reutilizar.
Un Nested Loops no es lento por definición y un Spool no es un error automático. En este plan importan juntos: la rama interior se solicita por cliente, ordena candidatos y usa una estructura temporal. Esa forma coincide con las 500 exploraciones de Worktable observadas en Messages.
La observación conduce a una hipótesis limitada: si clasificamos todos los pedidos relevantes una sola vez y después conservamos el primero de cada cliente, el resultado podría mantenerse con menos trabajo temporal. La hipótesis predice una reducción de lecturas; todavía debe probar equivalencia.
Clasificar el conjunto una sola vez
La alternativa utiliza ROW_NUMBER():
DECLARE @ClienteHasta int = 500;

WITH PedidosClasificados AS
(
    SELECT
        p.IdCliente,
        p.IdPedido,
        p.FechaPedido,
        p.Estado,
        p.Total,
        ROW_NUMBER() OVER
        (
            PARTITION BY p.IdCliente
            ORDER BY p.FechaPedido DESC, p.IdPedido DESC
        ) AS rn
    FROM dbo.PedidoLaboratorio AS p
    WHERE p.IdCliente BETWEEN 1 AND @ClienteHasta
      AND p.Estado IN ('Confirmado', 'Enviado')
)
SELECT
    IdCliente,
    IdPedido,
    FechaPedido,
    Estado,
    Total
FROM PedidosClasificados
WHERE rn = 1
ORDER BY IdCliente
OPTION (RECOMPILE);
Una función de ventana calcula un valor sobre filas relacionadas sin reunirlas en una sola fila. ROW_NUMBER() asigna una secuencia. PARTITION BY IdCliente reinicia esa secuencia para cada cliente y el ORDER BY coloca primero el pedido más reciente; rn = 1 conserva ese primer lugar.
La reescritura no es correcta solo porque parezca más compacta. Debe conservar también clientes, estados, totales y el desempate.
Probar todas las filas en ambos sentidos
Las dos salidas se guardaron en tablas temporales y se compararon con EXCEPT desde la original hacia la alternativa y de regreso:
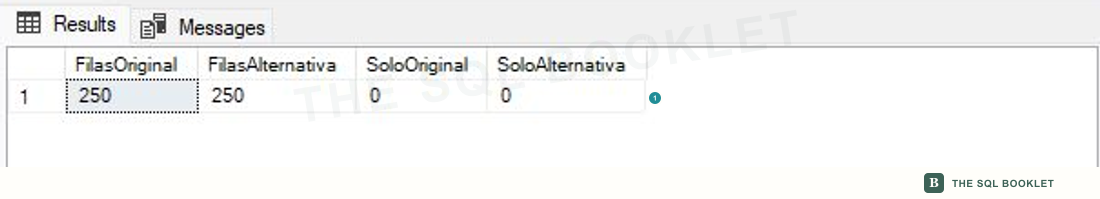
- 1Sin diferencias
Ambas variantes devuelven 250 filas; no aparece ninguna fila exclusiva en cualquiera de los dos sentidos.
EXCEPT devuelve filas de la primera consulta que no existen en la segunda. Ejecutarlo en ambas direcciones detecta faltantes y sobrantes. En este caso, los dos ceros sostienen que la alternativa conserva el resultado completo de la prueba.
Repetir la equivalencia con varios alcances
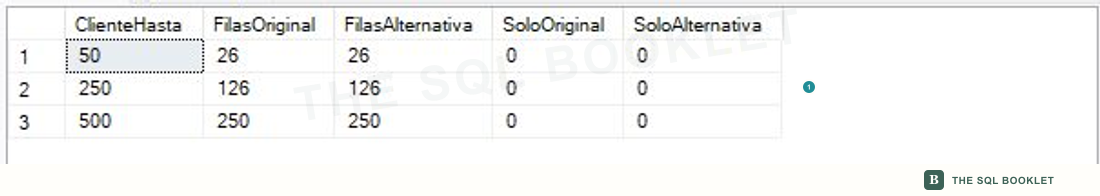
Una sola frontera todavía puede ocultar un caso particular. La misma comprobación se repitió sin cambiar las consultas para tres valores de @ClienteHasta:
- 1Tres contratos conservados
Los alcances 50, 250 y 500 devuelven 26, 126 y 250 filas en ambas variantes.
SoloOriginalySoloAlternativapermanecen en cero.
Esta repetición amplía la evidencia de equivalencia; no demuestra por sí sola que la alternativa sea más rápida para todos los parámetros. Las lecturas, el plan y los tiempos deben medirse de nuevo para cada distribución representativa.
Leer el nuevo plan sin declarar victoria
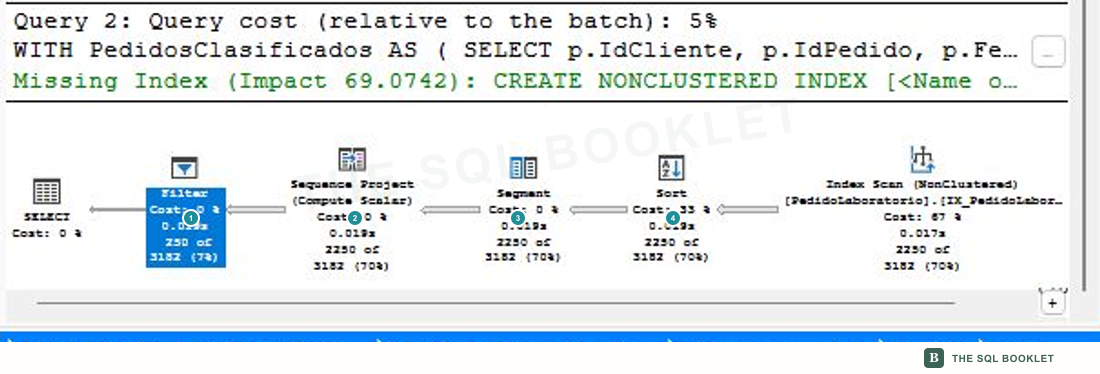
- 1Filter
Conserva las filas cuyo número calculado es uno.
- 2Sequence Project
Produce el número de fila que utiliza
ROW_NUMBER(). - 3Segment
Marca los límites entre clientes para reiniciar la numeración.
- 4Sort
Entrega las filas en el orden que necesita la función de ventana.
La alternativa procesó 2,250 pedidos relevantes y entregó 250. Eliminó el trabajo observado en Worktable, pero conserva un Sort: clasificar el conjunto sigue teniendo costo.
El plan también muestra una sugerencia de índice con impacto estimado de 69.0742 y estima 3,181.98 filas donde un operador entrega 250. Son señales pendientes, no instrucciones. La sugerencia debe someterse a otra prueba que incluya escrituras, almacenamiento y consultas afectadas; la diferencia de cardinalidad requiere revisar estadísticas, parámetros y distribución reales.
Concluir con el alcance correcto
La evidencia de esta prueba sostiene tres afirmaciones:
- las dos consultas devuelven las mismas 250 filas;
- la alternativa elimina las 500 exploraciones y 256,707 lecturas de
Worktableobservadas; - las lecturas de
PedidoLaboratoriopasan de 964 a 482 en la ejecución representativa.
No sostiene que ROW_NUMBER() siempre sea superior a CROSS APPLY, que todo Spool deba eliminarse ni que los tiempos medidos se repetirán en producción. Otra distribución, un índice diferente o un número menor de clientes puede favorecer otra estrategia.
Antes de trasladar el cambio hacen falta el texto que envía la aplicación, parámetros frecuentes y extremos, distribución de clientes y estados, índices y estadísticas vigentes, concurrencia, bloqueos, volumen de escrituras, espacio disponible y regresiones dentro de la carga completa.
Repetir el método con otra consulta
Elige una consulta empresarial y documenta, en este orden:
- el contrato exacto del resultado;
- una línea base con plan, lecturas y tiempos;
- una observación que pueda verificarse;
- una hipótesis que prediga un cambio medible;
- una alternativa y una prueba de equivalencia en ambos sentidos;
- una nueva medición bajo las mismas condiciones;
- las señales que permanecen y la información de producción que todavía falta.
Si no puedes explicar qué resultado debe conservarse o qué evidencia refutaría la hipótesis, el análisis todavía no está listo para proponer un cambio.
Relacionado con
- De una consulta lenta a una hipótesis comprobable: separa observación, causa provisional y predicción.
- Evaluar un cambio sin optimizar solo una ejecución: compara parámetros y repeticiones antes de generalizar.
- Construir una línea base repetible: conserva condiciones y mediciones comparables.
- Mapa de operadores: identifica el papel de cada nodo antes de juzgarlo.
- Leer una sugerencia Missing Index: trata la línea verde como candidato, no como orden.