
Filas estimadas y filas reales
SQL Server calcula cuántas filas espera en cada operador y, cuando capturamos un plan real, registra cuántas observó durante esa ejecución. Comparar ambas cifras permite localizar una suposición que no coincidió con los datos encontrados.
Dónde aparecen en SSMS
Activa Include Actual Execution Plan con Ctrl+M, ejecuta la consulta y abre la pestaña Execution plan. Después coloca el puntero sobre un operador. SSMS muestra una ficha con sus propiedades; también puedes seleccionarlo y presionar F4 para consultarlas en la ventana Properties.
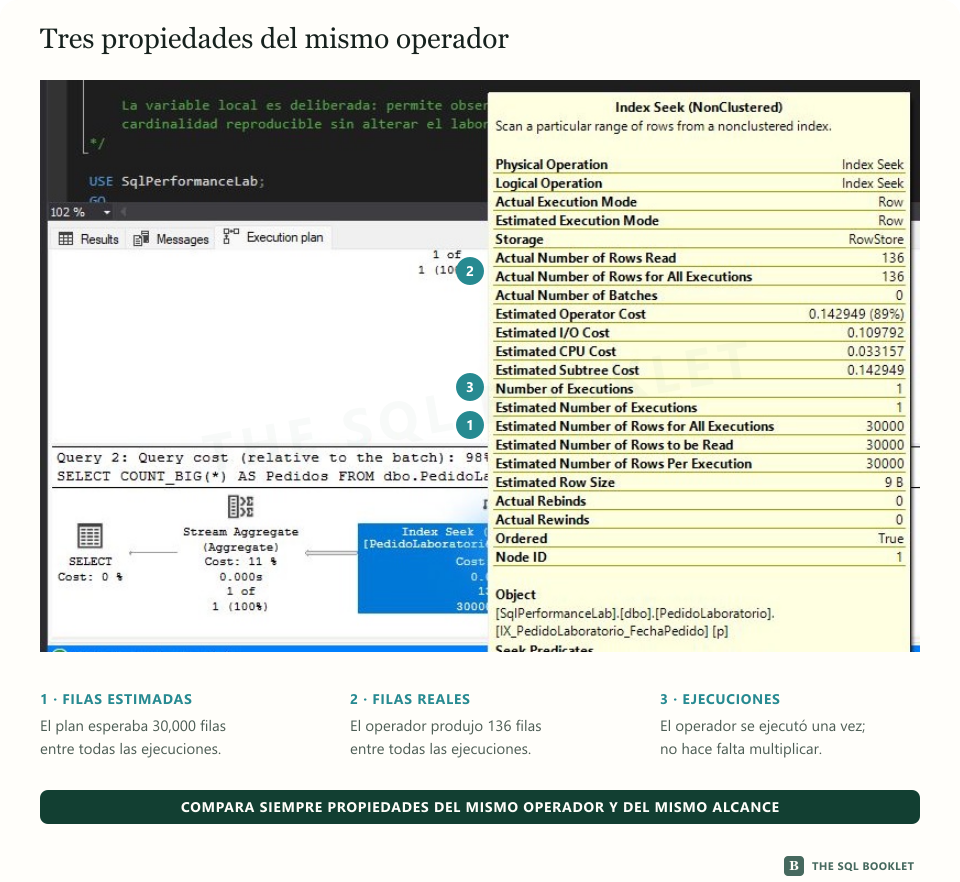
La captura muestra un Index Seek seleccionado en azul. Las marcas 1, 2 y 3 identifican las tres propiedades que necesitamos para esta lectura:
- Estimated Number of Rows For All Executions:
30000; - Actual Number of Rows For All Executions:
136; - Number of Executions:
1.
Los valores estimado y real pertenecen al mismo operador y cubren todas sus ejecuciones. En este caso el operador se ejecutó una vez, por lo que podemos comparar 30000 con 136 sin realizar otra multiplicación.
Dos cifras, dos momentos
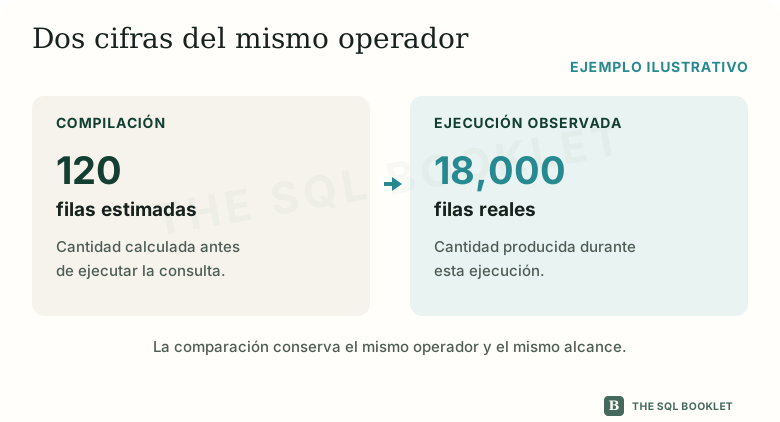
Las filas estimadas son la cantidad que el optimizador calcula durante la compilación. Ese cálculo forma parte de la estimación de cardinalidad: la predicción de cuántas filas producirá una operación en un punto del plan.
La cardinalidad es una cantidad de filas. El plan contiene una estimación para cada operador porque el resultado de una operación se convierte en la entrada de la siguiente.
Las filas reales son las filas que el operador produjo durante la ejecución observada. Solo aparecen cuando la consulta se ejecutó y se capturó información de ejecución, como ocurre en un plan real.
“Real” no significa permanente ni universal. Describe lo ocurrido con esos datos, parámetros y condiciones. Otra ejecución puede producir una cantidad diferente.
La comparación pertenece al mismo operador
Debemos comparar los valores estimado y real del mismo operador. Comparar la estimación de una entrada con las filas reales de otra rama mezcla puntos distintos del plan.
También necesitamos conservar el mismo alcance. Las propiedades pueden presentar valores por ejecución, acumulados para todas las ejecuciones o distribuidos entre varios hilos. Antes de calcular una diferencia conviene revisar:
- el nombre completo de cada propiedad;
- el número de ejecuciones del operador;
- si la cifra ya reúne todas las ejecuciones;
- si existe un desglose por hilo.
Si un valor ya representa todas las ejecuciones, volver a multiplicarlo por el número de ejecuciones duplicaría la cantidad.
Tres relaciones que podemos encontrar
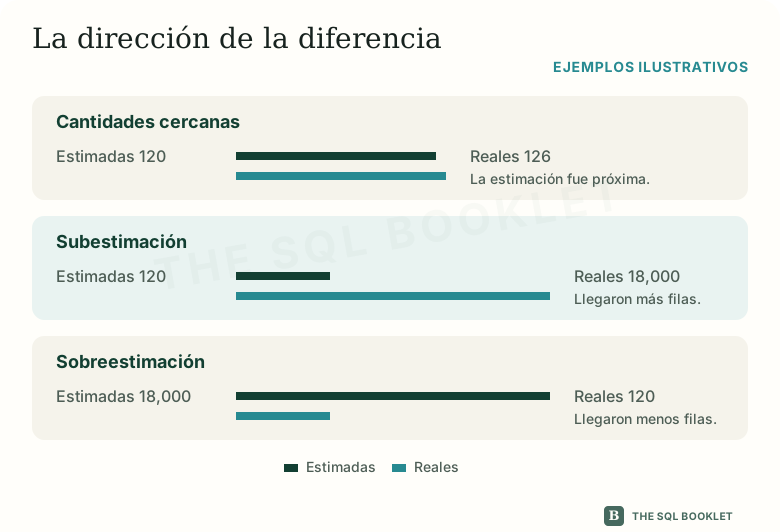
Cuando las cantidades son cercanas, la estimación describió razonablemente esa parte de la ejecución. No necesitan ser idénticas para resultar útiles.
Una subestimación ocurre cuando el operador produce muchas más filas de las previstas. SQL Server preparó esa parte del plan para una entrada menor que la observada.
Una sobreestimación ocurre cuando el operador produce muchas menos filas de las previstas. El plan se preparó considerando un volumen que no apareció en esa ejecución.
Estos nombres describen la dirección de la diferencia. Todavía no explican su causa ni demuestran que el operador deba cambiarse.
Por qué la diferencia merece atención
El optimizador utiliza la cardinalidad estimada como entrada de su modelo de costos. Con ella compara métodos de acceso, estrategias de unión, orden de las operaciones y necesidades de memoria.
Si una rama entrega una cantidad muy distinta, los operadores posteriores reciben un volumen diferente del que se consideró al compilar. La diferencia puede propagarse: una estimación imprecisa al comienzo de una rama puede influir en varias decisiones posteriores.
El efecto no depende únicamente de cuántas veces se separan las cifras. También importa dónde comienza la diferencia, cuántos operadores la reciben, cuántas veces se ejecutan y qué trabajo realizan con esas filas.
Por eso no adoptamos una regla universal como “diez veces es un problema”. Una diferencia grande puede tener poco impacto en una rama pequeña, mientras una diferencia menor puede acumularse dentro de una operación repetida.
Preguntas que abre una diferencia
Una separación importante permite formular preguntas concretas:
- ¿las estadísticas describen la distribución actual de los datos?;
- ¿el valor consultado aparece con una frecuencia poco común?;
- ¿el parámetro utilizado al compilar representa esta ejecución?;
- ¿el predicado contiene una expresión, variable o función que limita la información disponible para estimar?;
- ¿la diferencia comienza en este operador o llega desde una entrada anterior?;
Las estadísticas resumen cómo se distribuyen determinados valores. La distribución describe con qué frecuencia aparecen: algunos pueden repetirse mucho y otros casi nunca. El optimizador utiliza esa información, junto con otras reglas, para aproximar cuántas filas cumplirá un predicado.
Estas preguntas son hipótesis de investigación. Una diferencia entre filas estimadas y reales no autoriza por sí sola a actualizar estadísticas, crear un índice, recompilar un procedimiento o reescribir la consulta.
Separar observación, hipótesis y comprobación
Una lectura prudente puede documentarse así:
- Observación: el operador estimó 30,000 filas y produjo 136 en esta ejecución.
- Hipótesis: la distribución, las estadísticas, el parámetro o el predicado podrían explicar la diferencia.
- Comprobación pendiente: localizar dónde comienza la separación y revisar la evidencia correspondiente antes de proponer un cambio.
Esta forma conserva visible qué sabemos y qué todavía necesitamos demostrar.
Qué conclusión todavía no permite obtener
Una estimación cercana no demuestra que la consulta sea rápida. Una estimación distante tampoco prueba por sí sola que sea lenta ni que esa diferencia sea la causa principal del síntoma observado.
Para evaluar el impacto todavía debemos relacionar las cantidades con filas leídas, ejecuciones, predicados, memoria, lecturas, CPU y duración. El plan aporta una señal; la medición y el contexto determinan cuánto importa.
Siguiente comprobación razonable
La siguiente entrada distingue Index Seek, Index Scan y Table Scan. Allí relacionaremos el método de acceso con las filas leídas, las filas entregadas y el predicado aplicado.