
Evaluar un cambio sin optimizar solo una ejecución
Una alternativa no se valida porque una ejecución termine rápido. Debe conservar el resultado, repetir el beneficio con parámetros distintos y mostrar qué aspectos mejoran, cuáles permanecen iguales y cuáles todavía no fueron probados.
Recuperar la hipótesis
La entrada anterior observó 482 lecturas lógicas y un Index Scan que examinó 100,000 filas para entregar 136. La explicación provisional señaló las funciones aplicadas sobre FechaPedido:
WHERE YEAR(p.FechaPedido) = YEAR(@FechaObjetivo)
  AND MONTH(p.FechaPedido) = MONTH(@FechaObjetivo)
  AND DAY(p.FechaPedido) = DAY(@FechaObjetivo)
La alternativa expresa el mismo día como un intervalo:
WHERE p.FechaPedido >= @FechaObjetivo
  AND p.FechaPedido < DATEADD(DAY, 1, @FechaObjetivo)
La predicción es comprobable: el intervalo debe conservar cantidades e importes y reducir el trabajo de lectura. Si alguno de esos resultados no aparece, la hipótesis pierde apoyo.
Elegir parámetros antes de medir
La tabla contiene 730 fechas distintas. Para evitar que una sola fecha decida la conclusión, la prueba toma tres posiciones del intervalo disponible:
| Posición | Fecha | Filas |
|---|---|---|
| Inicial | 2024-01-01 |
137 |
| Media | 2024-12-30 |
137 |
| Final | 2025-12-30 |
136 |
Estas fechas comprueban que el comportamiento se repite en puntos separados. No representan una distribución sesgada: los tres días contienen volúmenes semejantes. Una carga con días vacíos, cierres de mes o concentraciones excepcionales necesitaría parámetros adicionales.
Comprobar equivalencia antes de comparar rendimiento
Ambas variantes se agrupan por fecha y estado. La comprobación conserva por separado cantidades e importes:
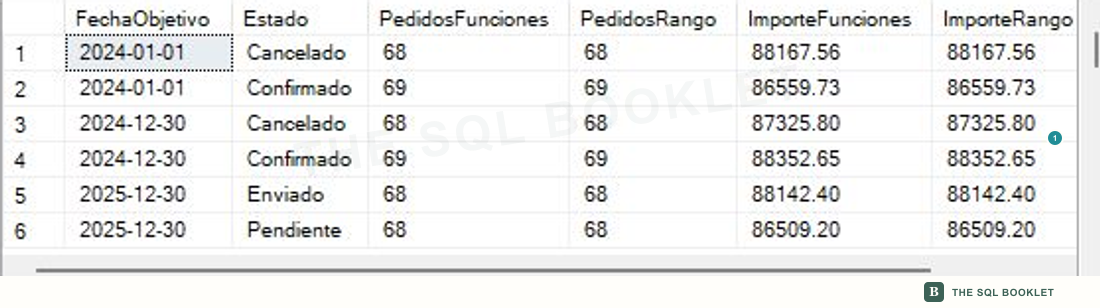
- 1Mismo resultado
Las columnas de funciones y rango coinciden en los seis grupos comparados.
La igualdad incluye las horas almacenadas dentro de cada día. El límite inferior acepta el inicio de la fecha y el superior excluye el inicio del día siguiente; no depende de que FechaPedido termine a medianoche.
Separar calentamiento y medición
Cada variante se ejecuta una vez por fecha con una etiqueta de calentamiento. Después comienza una serie distinta, con texto identificable en la caché:
/* PE29_FUNCIONES_MEDIDA_20261030 */
SELECT
    p.Estado,
    COUNT_BIG(*) AS Pedidos,
    SUM(p.Total) AS ImporteTotal
FROM dbo.PedidoLaboratorio AS p
WHERE YEAR(p.FechaPedido) = YEAR(@FechaObjetivo)
  AND MONTH(p.FechaPedido) = MONTH(@FechaObjetivo)
  AND DAY(p.FechaPedido) = DAY(@FechaObjetivo)
GROUP BY p.Estado
ORDER BY ImporteTotal DESC;
/* PE29_RANGO_MEDIDA_20261030 */
SELECT
p.Estado,
COUNT_BIG(*) AS Pedidos,
SUM(p.Total) AS ImporteTotal
FROM dbo.PedidoLaboratorio AS p
WHERE p.FechaPedido >= @FechaObjetivo
AND p.FechaPedido < DATEADD(DAY, 1, @FechaObjetivo)
GROUP BY p.Estado
ORDER BY ImporteTotal DESC;La prueba alterna ambas consultas cinco veces para cada fecha. Así reúne 15 ejecuciones medidas por variante sin ejecutar primero toda una serie y después la otra.
Alternar no elimina la actividad del equipo ni convierte la prueba en un benchmark de producción. Evita una diferencia básica de orden y permite observar si las lecturas se mantienen dentro de cada variante.
Comparar trabajo repetido
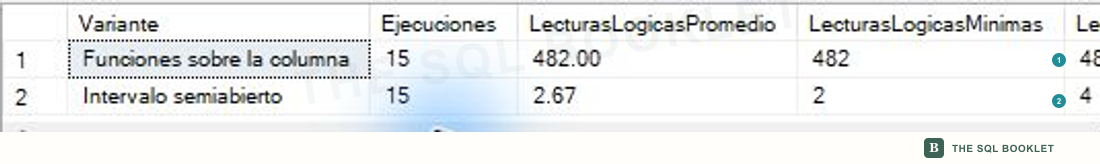
- 1Funciones
Las 15 ejecuciones registran 482 lecturas lógicas: mínimo, máximo y promedio permanecen en 482.
- 2Intervalo
Las 15 ejecuciones registran entre 2 y 4 lecturas lógicas, con promedio de 2.67.
La repetición sostiene la predicción dentro de estas tres fechas. No demuestra que cualquier consulta de fechas obtendrá la misma diferencia: el tamaño del índice, la distribución y el intervalo solicitado pueden cambiar el trabajo.
Leer tiempos como una distribución observada
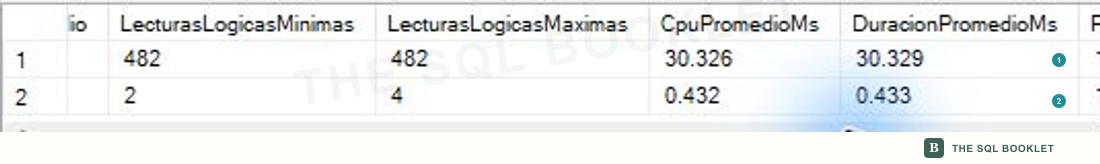
- 1Funciones
La media observada fue 30.326 ms de CPU y 30.329 ms de duración.
- 2Intervalo
La media observada fue 0.432 ms de CPU y 0.433 ms de duración.
sys.dm_exec_query_stats acumuló las 15 ejecuciones y mostró un plan en caché para cada texto medido. Este dato describe la ventana de prueba. No garantiza que el mismo plan permanecerá estable después de reinicios, cambios de estadísticas, compilaciones o parámetros con otra distribución.
Los tiempos acompañan a las lecturas, pero no se convierten en un porcentaje comercial de mejora. Son demasiado dependientes del equipo y de esta carga controlada para trasladarlos sin otra medición.
Comparar los planes reales
La variante con funciones conserva el recorrido observado en la hipótesis:
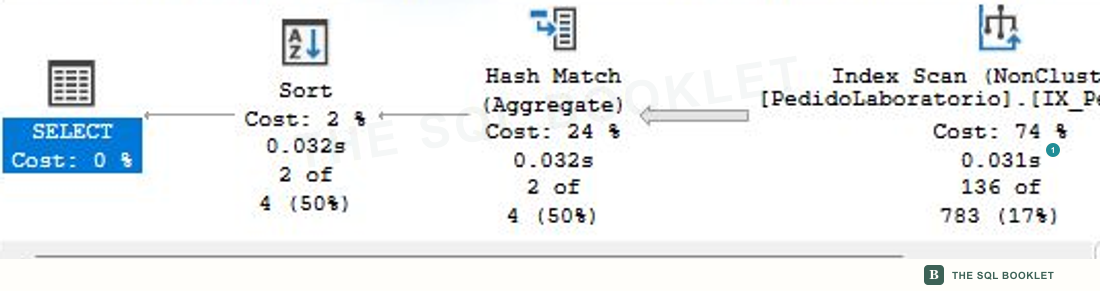
- 1Index Scan
El operador recorre el índice por fecha y aplica el predicado a las filas examinadas.
El intervalo permite un acceso diferente:
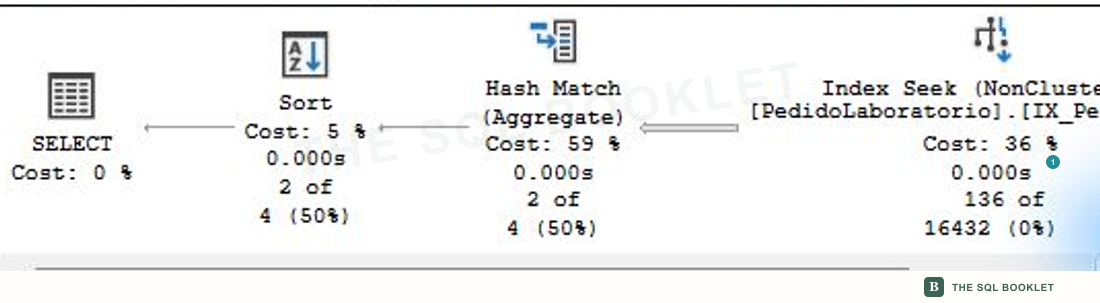
- 1Index Seek
Los límites forman un rango sobre la clave
FechaPedido.
El Hash Match (Aggregate) y el Sort siguen presentes porque la consulta todavía agrupa y ordena. El cambio atiende el acceso a las filas; no elimina el trabajo que exige formar el resultado.
Verificar filas leídas y una señal pendiente
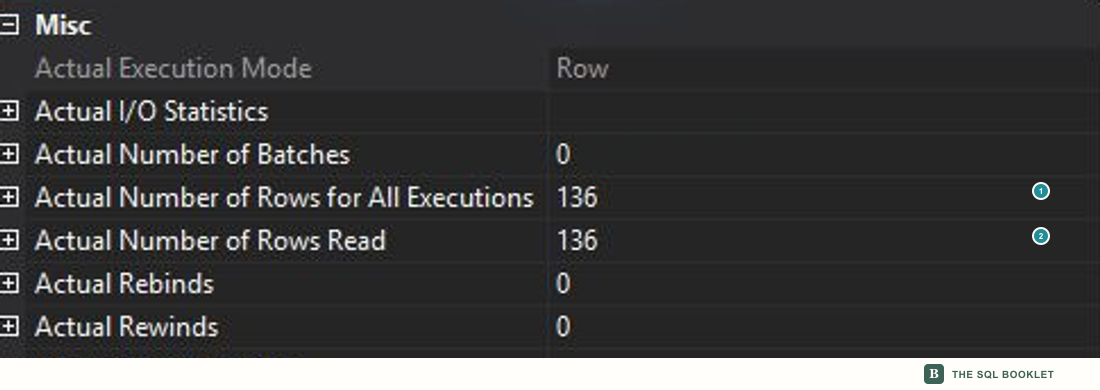
- 1Filas entregadas
El operador entrega las 136 filas del día final.
- 2Filas leídas
El operador lee esas mismas 136 filas, en lugar de examinar las 100,000 de la estructura.
El plan representativo del intervalo estimó 16,432 filas y observó 136. El método de acceso mejoró, pero la estimación no quedó alineada. Una corrección no tiene que resolver todas las señales del plan para ser útil; tampoco debe ocultar las que permanecen.
En esta consulta la fecha se declara en una variable local. Esa forma puede limitar la información disponible durante la compilación. La estimación merece una prueba separada con la forma real en que la aplicación envía el parámetro antes de atribuirle una causa definitiva.
Revisar efectos fuera de la medición
- Parámetros distintos: tres fechas separadas conservaron resultados y diferencia de lecturas; falta probar distribuciones extremas.
- Escrituras: el cambio modifica el predicado y no agrega mantenimiento a
INSERT,UPDATEoDELETE. - Almacenamiento: no se creó otro índice; el espacio de estructuras permanece igual.
- Otros planes: la prueba cubre este texto. No demuestra cómo reaccionan otras consultas sobre
FechaPedido. - Bloqueo: no hubo carga concurrente. Leer menos páginas puede reducir trabajo, pero esta prueba no midió esperas ni duración de bloqueos.
- Estabilidad: hubo un plan en caché por variante durante la serie; no es evidencia de estabilidad a largo plazo.
Decidir con el alcance correcto
La hipótesis recibe apoyo dentro de la prueba: el intervalo conserva los resultados, cambia el acceso de Scan a Seek y reduce las lecturas en las 15 ejecuciones medidas. Puede avanzar como modificación candidata para esta consulta.
Antes de aplicarla en otro sistema todavía hacen falta el texto que realmente envía la aplicación, parámetros representativos de su distribución, concurrencia, estadísticas vigentes y una comparación dentro de la carga completa. La conclusión es más útil cuando también declara lo que no sabe.
Siguiente comprobación razonable
La siguiente entrada reunirá el método completo en un caso empresarial reproducible: contexto, línea base, plan, métricas, hipótesis, cambio, nueva medición y conclusión limitada por la evidencia.
Relacionado con
- De una consulta lenta a una hipótesis comprobable: formula la explicación que esta prueba evalúa.
- Construir una línea base repetible: separa condiciones, calentamiento y medición.
- Guardar y comparar dos planes: conserva las formas de acceso antes y después.
- CPU y duración con SET STATISTICS TIME: interpreta tiempos sin aislarlos del resto de la evidencia.