
Mapa de operadores: qué papel cumple cada nodo
Un plan pequeño puede contener búsquedas, filtros, uniones, cálculos y ordenamientos en la misma rama. Leer los nombres como una lista aislada obliga a memorizar iconos; agruparlos por la función que cumplen permite reconstruir el trabajo del plan.
El nombre describe una operación
Cada recuadro del plan es un operador: una unidad de trabajo que recibe filas, realiza una operación y entrega filas al siguiente nodo. Algunos operadores leen una tabla o un índice; otros transforman, combinan, ordenan o conservan las filas que recibieron.
El icono ayuda a localizar el nodo, pero no basta para interpretarlo. Dos operadores pueden compartir un icono o una palabra y realizar trabajos distintos. Hash Match, por ejemplo, puede participar en una unión o en una agregación. Leemos el nombre completo, las entradas y las propiedades antes de asignarle un significado.
Operación lógica y operador físico
La operación lógica expresa qué necesita la consulta: unir conjuntos, ordenar filas o formar grupos. El operador físico describe el mecanismo elegido por SQL Server para realizar ese trabajo.
Una unión lógica puede ejecutarse mediante Nested Loops, Hash Match o Merge Join. La consulta conserva la misma intención lógica, pero el optimizador puede elegir mecanismos físicos diferentes según sus estimaciones, las estructuras disponibles y las propiedades requeridas.
No todos los nodos muestran ambos nombres de forma separada. Cuando los presentan, podemos consultarlos en la información emergente o en la ventana Properties mediante campos como Logical Operation y Physical Operation.
Siete familias para orientarnos
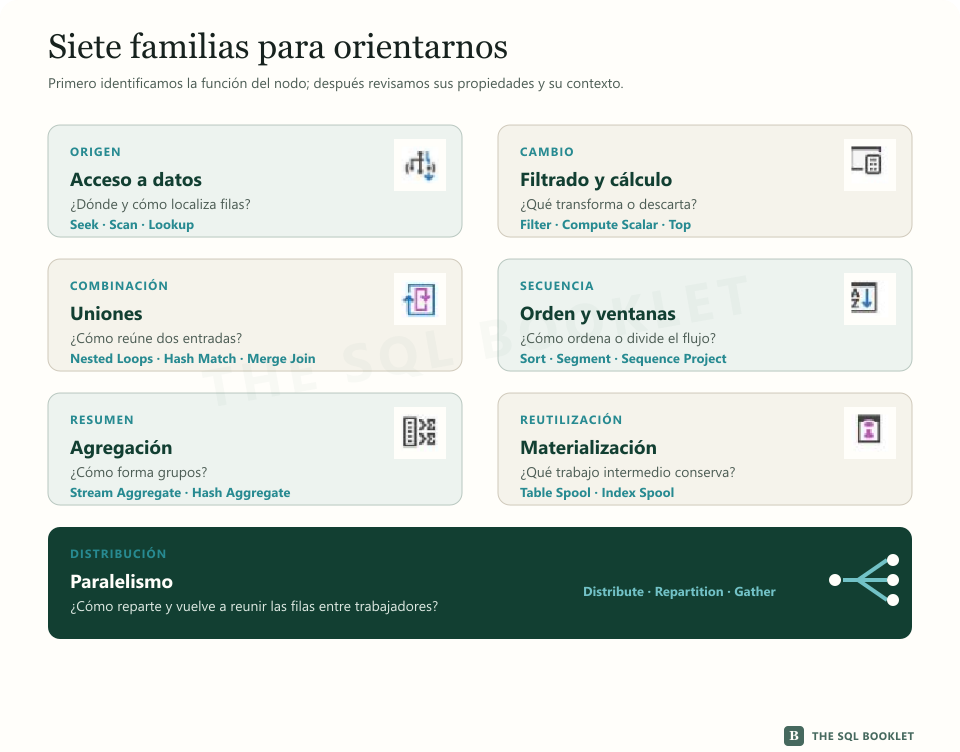
El mapa organiza operadores frecuentes por la pregunta que ayudan a responder. No califica una familia como buena o mala y tampoco sustituye la lectura de las propiedades del nodo.
Los seis primeros símbolos reproducen iconos utilizados por SSMS. En el mapa general, el símbolo de paralelismo resume la distribución de un flujo; las tiras de cada familia muestran después los iconos individuales con su nombre completo.
Acceso a datos
Responde de dónde salen las filas y cómo se localizaron. Aquí aparecen Index Seek, Index Scan, Table Scan y Key Lookup. Para interpretarlos revisamos el objeto utilizado, las filas leídas, las filas entregadas y los predicados.


Filtrado y cálculo
Responde qué expresión transforma o descarta filas. Filter aplica una condición; Compute Scalar incorpora el resultado de un cálculo; Top limita cuántas filas continúan. Su presencia describe trabajo, pero no demuestra por sí sola un problema.


Uniones
Responde cómo se combinaron dos entradas. Nested Loops, Hash Match y Merge Join son estrategias físicas diferentes para realizar una unión. Las examinamos junto con el volumen, el orden, la memoria y la cantidad de ejecuciones de cada entrada.


Orden y ventanas
Responde cómo se ordenaron o dividieron las filas para un cálculo posterior. Sort establece un orden; Segment marca límites entre grupos dentro de una entrada ordenada; Sequence Project agrega cálculos sobre esa secuencia, como una numeración.


Agregación
Responde cómo se redujeron filas a grupos o resultados acumulados. Stream Aggregate aprovecha una entrada ordenada; Hash Match (Aggregate) forma grupos mediante una estructura hash. Ambos pueden implementar una agregación, pero no requieren las mismas condiciones.


Materialización
Responde qué resultado intermedio se conservó para volver a utilizarlo. Los operadores Spool almacenan filas de manera temporal. Revisamos qué construyen, cuántas veces se reutilizan y si ese trabajo evita repetir una operación más costosa.


Paralelismo
Responde cómo se distribuyó el flujo entre varios trabajadores y cómo volvió a reunirse. Un operador Parallelism puede distribuir, repartir o reunir filas. Para entenderlo necesitamos leer la operación específica y no únicamente reconocer el icono.


La familia no determina el diagnóstico
Clasificar el operador establece su papel dentro de la rama. Todavía no indica si esa elección fue adecuada para el volumen real ni si explica el síntoma observado.
Un Scan puede ser razonable cuando la consulta necesita una parte amplia de la tabla. Un Sort puede ser necesario para obtener el orden solicitado. Un Spool puede evitar trabajo repetido. Incluso un operador con un costo estimado pequeño puede importar cuando se ejecuta miles de veces.
La evaluación comienza después de describir:
- qué filas recibe el operador;
- qué trabajo realiza;
- qué filas entrega;
- cuántas veces se ejecuta;
- qué estimó SQL Server y qué ocurrió durante la ejecución;
- qué propiedades o advertencias precisan esa lectura.
Cómo investigar un operador desconocido
Cuando aparece un nombre que todavía no conocemos, podemos conservar el hilo del plan sin adivinar:
- leemos el nombre completo del operador;
- identificamos cuántas entradas recibe y hacia dónde entrega filas;
- abrimos Properties y distinguimos operación lógica y física cuando estén disponibles;
- revisamos objeto, predicado, columnas producidas, filas y ejecuciones;
- consultamos la referencia del operador y regresamos al contexto de esa rama.
La definición explica el mecanismo general. El plan concreto muestra por qué participa en esa consulta y cuánto trabajo realizó en esa ejecución.
Qué conclusión todavía no permite obtener
Reconocer la familia de cada nodo no demuestra que el plan sea eficiente ni señala automáticamente qué debemos cambiar. Para evaluar una decisión necesitamos comparar estimaciones con observaciones y relacionarlas después con lecturas, CPU, duración, memoria y contexto de la carga.
Siguiente comprobación razonable
La siguiente entrada compara filas estimadas y filas reales dentro del mismo operador. Ese contraste permite pasar del papel general de cada nodo a una primera diferencia comprobable entre lo que SQL Server esperaba y lo que encontró.