
CPU y duración con SET STATISTICS TIME
Una consulta lenta no necesariamente mantiene ocupado al procesador durante todo ese tiempo. SET STATISTICS TIME separa el trabajo de CPU del tiempo transcurrido y también informa cuánto tardaron el análisis y la compilación.
Activar la medición
La opción se habilita en la sesión actual y escribe sus resultados en Messages:
SET STATISTICS TIME ON;

SELECT SUM(CONVERT(DECIMAL(38, 4), p.Total * f.Factor)) AS TotalCalculado
FROM dbo.PedidoLaboratorio AS p
CROSS JOIN
(
    VALUES (1), (2), (3), (4), (5), (6), (7), (8)
) AS f(Factor)
OPTION (MAXDOP 1, RECOMPILE);

SET STATISTICS TIME OFF;
Ejecuta el bloque completo con F5 y abre la pestaña Messages. La cuadrícula Results contiene el valor calculado, pero los tiempos aparecen en Messages bajo SQL Server parse and compile time y SQL Server Execution Times.
Las cifras cambian entre ejecuciones y equipos. Lo reproducible es la ubicación y la separación entre compilación, CPU y tiempo transcurrido, no los milisegundos exactos de la captura.
ON permanece activo para las instrucciones posteriores de la misma conexión. Conviene ejecutar OFF al terminar para que la pestaña Messages no mezcle mediciones de consultas distintas.
La consulta de esta prueba agrega cálculos deliberadamente y devuelve una sola fila. MAXDOP 1 limita esta ejecución a un trabajador para hacer más directa la primera lectura de CPU y duración; no es una recomendación general para consultas empresariales.
La salida separa compilación y ejecución
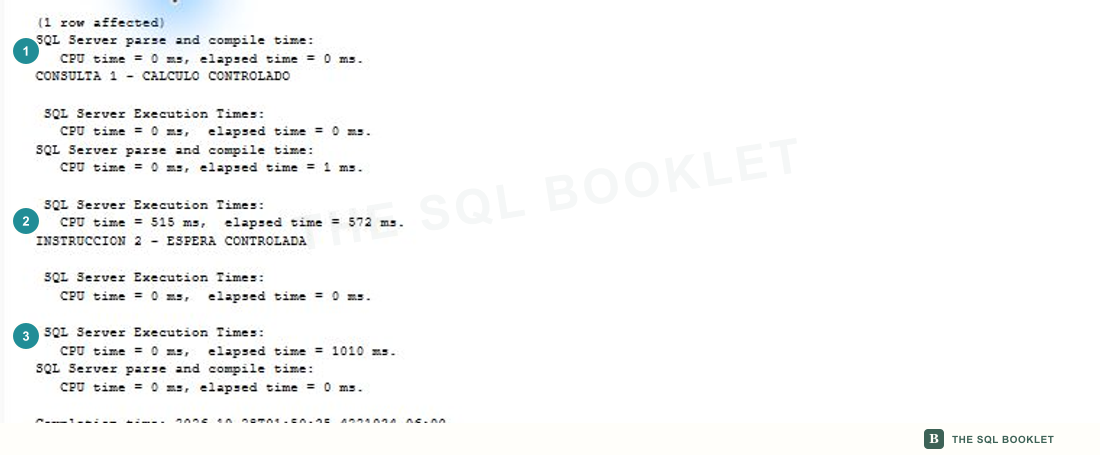
- 1Análisis y compilación
SQL Server parse and compile timeregistra el trabajo previo a ejecutar la instrucción. Los valores de esta prueba fueron de 0 y 1 ms. - 2Cálculo controlado
SQL Server Execution Timesinforma 515 ms de CPU y 572 ms transcurridos para la consulta que realiza el cálculo. - 3Espera controlada
La instrucción
WAITFORinforma 0 ms de CPU y 1010 ms transcurridos. El procesador no estuvo trabajando durante la mayor parte de esa espera.
Los mensajes de validación y otras instrucciones del lote también pueden producir grupos con valores cercanos a cero. Para interpretar una medición hay que relacionar cada bloque con la instrucción que lo precede.
parse and compile time: preparar la estrategia
Antes de ejecutar una consulta, SQL Server debe analizar el texto y disponer de un plan. parse time corresponde al análisis sintáctico; compile time reúne el trabajo necesario para compilar u optimizar la instrucción.
Un valor de 0 ms no demuestra que no ocurrió trabajo. Puede indicar que fue menor que la resolución del contador, que la instrucción era sencilla o que ya existía una estrategia reutilizable. En esta prueba se utiliza RECOMPILE para obtener una compilación controlada, no como recomendación para todas las consultas.
CPU time: trabajo acumulado del procesador
CPU time suma el tiempo durante el cual los trabajadores de la consulta utilizaron procesador. No incluye el tiempo en que permanecieron detenidos esperando datos, memoria, bloqueos u otros recursos.
Aquí la consulta queda limitada a un solo trabajador y registra 515 ms de CPU. En un plan paralelo varios trabajadores pueden utilizar CPU al mismo tiempo; como el contador acumula su trabajo, el total de CPU puede superar el tiempo transcurrido.
elapsed time: tiempo de principio a fin
elapsed time mide el tiempo de reloj desde que comienza la ejecución hasta que termina. Incluye el trabajo de CPU y los periodos en que la consulta no avanza porque espera programación, almacenamiento, bloqueos u otros recursos.
El cálculo registra 572 ms transcurridos frente a 515 ms de CPU. Esa cercanía describe esta ejecución, pero no identifica por sí sola dónde se empleó cada milisegundo ni permite extrapolar el resultado a otra carga.
Una espera puede durar sin consumir CPU
La segunda instrucción aísla esa diferencia:
WAITFOR DELAY '00:00:01';La espera dura aproximadamente un segundo y registra 0 ms de CPU. WAITFOR se utiliza aquí únicamente como contraste didáctico; no representa una técnica de optimización ni una forma de simular toda la variedad de esperas que puede encontrar una consulta real.
Una diferencia amplia entre duración y CPU indica que hubo tiempo sin uso activo del procesador por parte de la consulta. Para conocer la causa todavía hacen falta otras evidencias, como esperas, bloqueos, lecturas y el plan de ejecución.
Una ejecución no establece una tendencia
La duración puede cambiar por el estado de la caché, la compilación, los parámetros, el plan elegido, la actividad concurrente y los recursos disponibles. La primera ejecución sirve para observar; no basta para declarar una mejora o una regresión.
Una comparación útil conserva la consulta, los parámetros y las condiciones relevantes, repite la medición y registra la variación. También separa el tiempo del servidor del tiempo adicional que puede percibir una aplicación al transferir y procesar resultados.
Qué podemos concluir
En esta prueba, el cálculo empleó 515 ms de CPU durante 572 ms transcurridos. La espera controlada empleó 0 ms de CPU durante 1010 ms transcurridos. Los valores muestran que CPU y duración responden preguntas distintas; todavía no explican por sí solos la causa de un problema de rendimiento.
Siguiente comprobación razonable
La siguiente entrada construye una línea base repetible: conserva las condiciones de la prueba, reúne varias ejecuciones y compara una sola variable a la vez.