
Nested Loops, Hash Match y Merge Join
Una consulta puede escribir un solo INNER JOIN y obtener el mismo resultado mediante estrategias físicas distintas. El tipo de JOIN pertenece a la expresión lógica; Nested Loops, Hash Match y Merge Join describen cómo SQL Server relacionó las dos entradas.
Ninguno de los tres operadores es favorable o desfavorable por sí solo. Para interpretarlo necesitamos observar qué recibe, cómo busca coincidencias y qué trabajo acumula.
Los ejemplos aíslan cada estrategia mediante join hints para hacerla visible. OPTION y los query hints explica qué restringen estas indicaciones y por qué no deben convertirse automáticamente en una corrección permanente.
Cómo abrir los tres planes
La preparación de esta prueba crea #ClienteJoin y #PedidoJoin dentro de la misma conexión. Debe ejecutarse antes de las consultas de cada apartado; las tablas temporales dejan de existir al cerrar la ventana o al ejecutar la limpieza del bloque de preparación.
Ejecuta una vez este bloque en la misma ventana donde probarás las tres consultas:
IF OBJECT_ID(N'tempdb..#PedidoJoin', N'U') IS NOT NULL
    DROP TABLE #PedidoJoin;

IF OBJECT_ID(N'tempdb..#ClienteJoin', N'U') IS NOT NULL
    DROP TABLE #ClienteJoin;

CREATE TABLE #ClienteJoin
(
    IdCliente INT NOT NULL,
    Segmento  VARCHAR(20) NOT NULL,
    CONSTRAINT PK_ClienteJoin
        PRIMARY KEY CLUSTERED (IdCliente)
);

CREATE TABLE #PedidoJoin
(
    IdCliente   INT NOT NULL,
    IdPedido    INT NOT NULL,
    FechaPedido DATE NOT NULL,
    Total       DECIMAL(12, 2) NOT NULL,
    CONSTRAINT PK_PedidoJoin
        PRIMARY KEY CLUSTERED (IdCliente, IdPedido)
);

INSERT INTO #ClienteJoin
    (IdCliente, Segmento)
SELECT
    clientes.IdCliente,
    CASE clientes.IdCliente % 3
        WHEN 0 THEN 'Empresarial'
        WHEN 1 THEN 'Profesional'
        ELSE 'Inicial'
    END
FROM
(
    SELECT DISTINCT p.IdCliente
    FROM dbo.PedidoLaboratorio AS p
) AS clientes;

INSERT INTO #PedidoJoin
    (IdCliente, IdPedido, FechaPedido, Total)
SELECT
    p.IdCliente,
    p.IdPedido,
    p.FechaPedido,
    p.Total
FROM dbo.PedidoLaboratorio AS p;
Activa Include Actual Execution Plan con Ctrl+M y ejecuta cada caso por separado después de preparar las tablas. Abre Execution plan y confirma el nombre completo del operador central: Nested Loops, Hash Match (Inner Join) o Merge Join. Los hints de esta entrada aíslan los mecanismos para estudiarlos; no indican cuál debería imponerse en una aplicación.
Dos entradas y una condición
Un operador de unión recibe dos conjuntos de filas. La condición indica qué valores pueden coincidir; el operador físico define el procedimiento utilizado para encontrarlos.
SELECT
    c.IdCliente,
    c.Segmento,
    p.IdPedido,
    p.Total
FROM #ClienteJoin AS c
INNER JOIN #PedidoJoin AS p
    ON p.IdCliente = c.IdCliente;
La consulta no ordena a SQL Server usar ciclos, una tabla hash o entradas ordenadas. El optimizador compara alternativas a partir de las filas estimadas, los índices, el orden disponible, la memoria y el costo calculado.
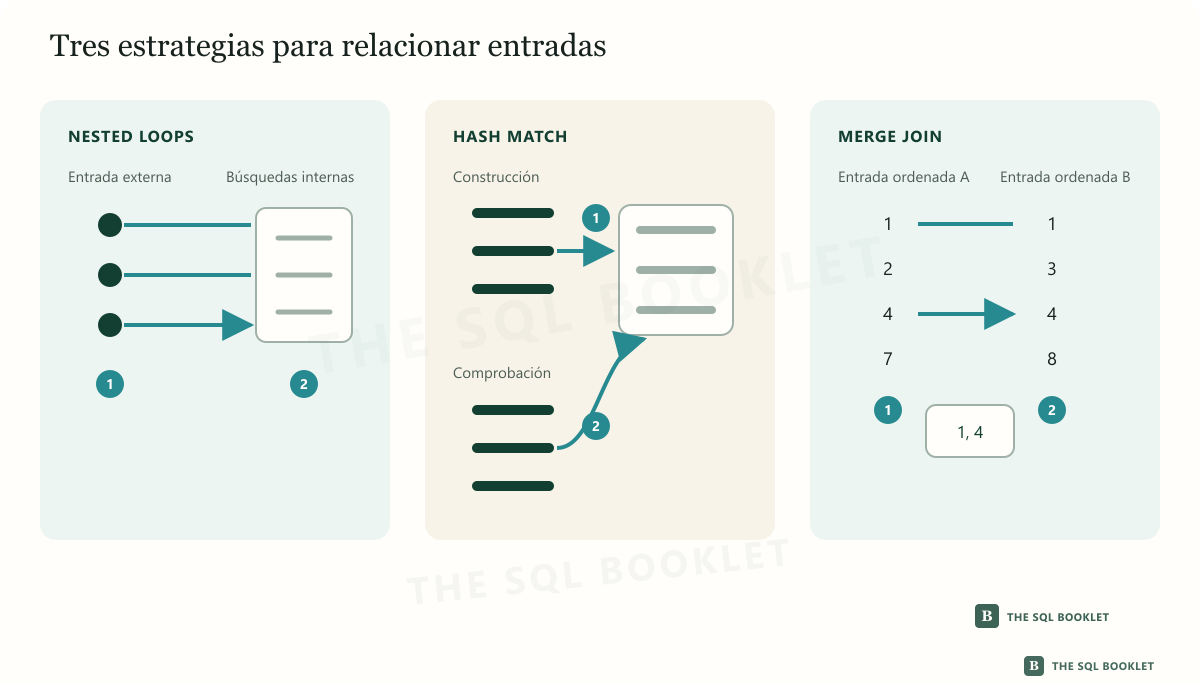
Las capturas siguientes provienen de la misma prueba controlada, con 12,000 clientes y 100,000 pedidos ficticios. Los hints LOOP, HASH y MERGE aíslan cada estrategia con fines didácticos; no son una recomendación para las consultas de una aplicación.
Nested Loops
Nested Loops toma una fila de la entrada externa y solicita coincidencias a la entrada interna. Repite esa solicitud por cada fila externa.
- 1Entrada externa
Entrega las filas que inician cada ciclo.
- 2Entrada interna
Busca las coincidencias solicitadas por la fila externa actual.
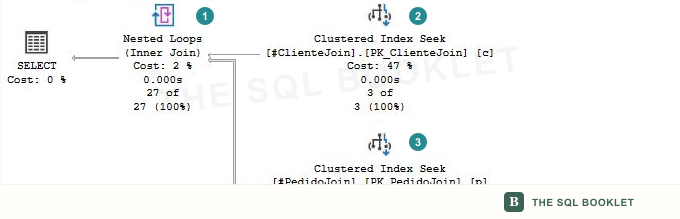
- 1Operador de unión
Nested Loopscoordina las dos ramas y entrega las filas que cumplen la condición. - 2Entrada externa
El primer
Clustered Index Seekentrega los tres clientes que inician los ciclos. - 3Entrada interna
El segundo
Clustered Index Seekbusca los pedidos correspondientes a cada cliente recibido.
Consulta que produce el plan
El filtro limita la entrada externa a tres clientes. INNER LOOP JOIN permite observar cómo cada cliente inicia una búsqueda en la entrada interna.
SELECT
    c.IdCliente,
    c.Segmento,
    p.IdPedido,
    p.FechaPedido,
    p.Total
FROM #ClienteJoin AS c
INNER LOOP JOIN #PedidoJoin AS p
    ON p.IdCliente = c.IdCliente
WHERE c.IdCliente BETWEEN 1 AND 3
ORDER BY
    c.IdCliente,
    p.IdPedido
OPTION (RECOMPILE);
Una entrada externa pequeña y un acceso interno selectivo pueden formar una combinación eficiente. El mismo mecanismo acumula trabajo cuando recibe muchas filas externas o cada búsqueda lee más de lo esperado.
En el plan conviene relacionar Actual Number of Rows de la entrada externa con Number of Executions de la rama interna. En el ejemplo de Key Lookup, 90 localizadores produjeron 90 solicitudes de recuperación.
Hash Match
Hash Match asigna funciones distintas a sus entradas. La entrada de construcción se utiliza para crear en memoria una tabla hash organizada por la llave de unión. Después, cada fila de la entrada de comprobación calcula la misma función hash y busca el grupo donde podrían estar sus coincidencias.
- 1Construcción
Forma la tabla hash con una de las entradas.
- 2Comprobación
Consulta esa estructura con las filas de la otra entrada.
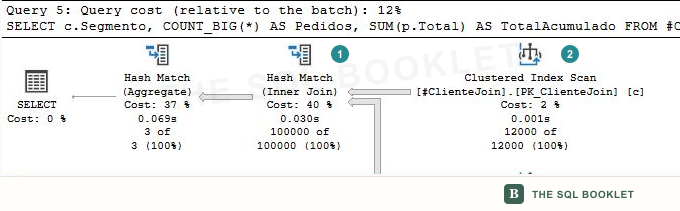
- 1Unión por hash
El operador relevante es
Hash Match (Inner Join). ElHash Match (Aggregate)situado a su izquierda consume el resultado para agruparlo y cumple otra función. - 2Una entrada visible
El
Clustered Index Scanlee una de las tablas temporales. La función build o probe de cada entrada debe confirmarse en las propiedades; no se deduce con seguridad por su posición en el dibujo.
Consulta que produce el plan
Esta consulta procesa los conjuntos amplios sin depender de un orden previo. INNER HASH JOIN permite aislar la construcción y comprobación de la tabla hash.
SELECT
    c.Segmento,
    COUNT_BIG(*) AS Pedidos,
    SUM(p.Total) AS TotalAcumulado
FROM #ClienteJoin AS c
INNER HASH JOIN #PedidoJoin AS p
    ON p.IdCliente = c.IdCliente
GROUP BY c.Segmento
OPTION (RECOMPILE);
Esta estrategia no necesita que las entradas lleguen ordenadas y puede relacionar conjuntos amplios por igualdad. Sí necesita memoria para construir la tabla hash. Si la concesión no alcanza, parte del trabajo puede pasar a tempdb; esa situación se comprueba mediante las propiedades y advertencias del plan real, no mediante el nombre Hash Match aislado.
En las propiedades aparecen Hash Keys Build y Hash Keys Probe. Indican las columnas utilizadas para construir y consultar la tabla hash. Memory Grant, las filas reales y cualquier advertencia de derrame completan la lectura.
Merge Join
Merge Join recibe ambas entradas ordenadas por las llaves de unión. Compara los valores actuales y avanza por la entrada que contiene el valor menor; cuando los valores coinciden, produce las filas correspondientes.
- 1Primera entrada ordenada
Avanza por la llave de unión sin volver al inicio.
- 2Segunda entrada ordenada
Avanza en paralelo y entrega las coincidencias.
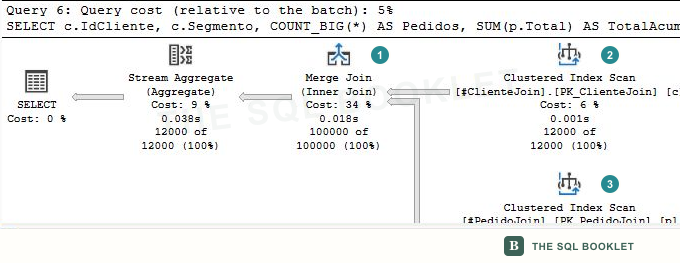
- 1Unión ordenada
Merge Join (Inner Join)compara las llaves que recibe de ambas ramas. - 2Primera entrada
El
Clustered Index Scanrecorre#ClienteJoinen el orden de su índice clustered. - 3Segunda entrada
El otro
Clustered Index Scanrecorre#PedidoJoincon la misma llave de unión disponible en orden.
Consulta que produce el plan
Los índices clustered entregan ambas entradas ordenadas por IdCliente. INNER MERGE JOIN permite comprobar cómo el operador aprovecha ese orden sin añadir un Sort.
SELECT
    c.IdCliente,
    c.Segmento,
    COUNT_BIG(*) AS Pedidos,
    SUM(p.Total) AS TotalAcumulado
FROM #ClienteJoin AS c
INNER MERGE JOIN #PedidoJoin AS p
    ON p.IdCliente = c.IdCliente
GROUP BY
    c.IdCliente,
    c.Segmento
OPTION (RECOMPILE);
El orden puede provenir de un índice o de un operador Sort. Cuando ya existe, Merge Join puede recorrer entradas amplias de forma continua. Cuando debe producirse exclusivamente para la unión, el costo y la memoria del ordenamiento también forman parte de la estrategia.
Las propiedades Merge Columns muestran las llaves utilizadas. El árbol permite comprobar si las ramas conservaban un orden útil o si apareció un Sort. Una unión many-to-many también puede necesitar una tabla de trabajo para manejar valores duplicados.
Qué revisar en el plan
| Operador | Observa primero | Pregunta siguiente |
|---|---|---|
Nested Loops |
Filas externas y ejecuciones internas | ¿La repetición produce búsquedas puntuales o lecturas acumuladas? |
Hash Match |
Entradas build/probe, memoria y advertencias | ¿La tabla hash permaneció en memoria o hubo derrame? |
Merge Join |
Orden de ambas entradas y operadores Sort |
¿El orden ya existía o tuvo que producirse? |
Después compara filas estimadas y reales. Una estimación incorrecta puede hacer atractiva durante la compilación una estrategia que acumula más trabajo con las filas observadas.
Cuando termines las tres comprobaciones, elimina las tablas temporales o cierra la ventana de consulta:
DROP TABLE IF EXISTS #PedidoJoin;
DROP TABLE IF EXISTS #ClienteJoin;
Qué conclusión todavía no permite obtener
El operador no demuestra por sí solo que la consulta esté optimizada. Un Nested Loops puede ser adecuado para pocas búsquedas y costoso al repetirse; un Hash Match puede resolver entradas amplias en memoria o derramarse; un Merge Join puede aprovechar índices ordenados o depender de ordenamientos adicionales.
Tampoco conviene forzar un algoritmo porque funcionó una vez. El volumen, la distribución, los parámetros, los índices, la memoria y la concurrencia pueden cambiar la alternativa de menor costo.