
Decidir, crear y comprobar un índice
Una sugerencia de índice se convierte en una decisión cuando se compara con las estructuras existentes, se prueba con la misma consulta y se documentan tanto el beneficio como el costo agregado. En esta prueba, el candidato reduce las lecturas de una consulta concreta; el resultado permite conservarlo como hipótesis útil, no aprobarlo para cualquier carga.
Revisar lo que ya existe
Antes de crear una estructura, consulta las columnas clave, las columnas incluidas y el espacio ocupado por cada índice de la tabla:
SELECT
    i.name AS Indice,
    i.type_desc AS Tipo,
    ic.key_ordinal AS OrdenClave,
    ic.is_included_column AS EsIncluida,
    c.name AS Columna,
    sz.PaginasUsadas,
    CONVERT(DECIMAL(12, 2), sz.PaginasUsadas * 8.0 / 1024.0) AS TamanoMB
FROM sys.indexes AS i
INNER JOIN sys.index_columns AS ic
    ON ic.object_id = i.object_id
   AND ic.index_id = i.index_id
INNER JOIN sys.columns AS c
    ON c.object_id = ic.object_id
   AND c.column_id = ic.column_id
CROSS APPLY
(
    SELECT SUM(ps.used_page_count) AS PaginasUsadas
    FROM sys.dm_db_partition_stats AS ps
    WHERE ps.object_id = i.object_id
      AND ps.index_id = i.index_id
) AS sz
WHERE i.object_id = OBJECT_ID(N'dbo.PedidoLaboratorio')
  AND i.index_id > 0
ORDER BY
    i.name,
    ic.is_included_column,
    ic.key_ordinal,
    ic.index_column_id;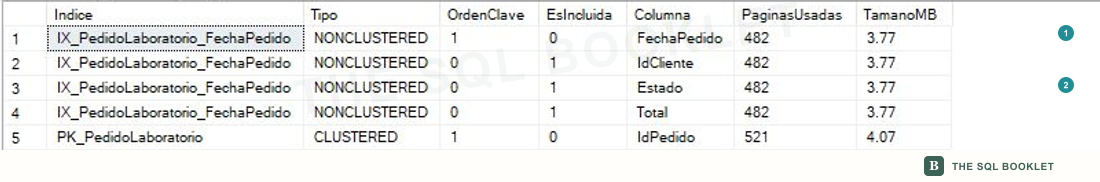
- 1Clave actual
FechaPedidoocupa el primer lugar de la clave del índice no clustered. - 2Datos incluidos
IdCliente,EstadoyTotalestán almacenados en sus hojas, pero no determinan cómo se recorre el índice.
El índice existente contiene las tres columnas que necesita la consulta, pero su clave comienza con FechaPedido. Como la consulta no filtra por fecha, tener Estado y Total como columnas incluidas no permite localizar directamente el intervalo solicitado.
Este es un solapamiento de cobertura, no un solapamiento de navegación. Dos índices se solapan en cobertura cuando almacenan datos semejantes; se solapan en navegación cuando sus claves iniciales permiten resolver búsquedas semejantes. Distinguirlos evita concluir que dos estructuras son equivalentes solo porque repiten nombres de columnas.
Conservar una línea base antes del cambio
La comparación utiliza exactamente la misma consulta y los mismos valores antes y después:
SET STATISTICS IO ON;
SET STATISTICS TIME ON;

SELECT TOP (10)
    p.IdCliente,
    COUNT_BIG(*) AS Pedidos,
    SUM(p.Total) AS Importe
FROM dbo.PedidoLaboratorio AS p
WHERE p.Estado = 'Enviado'
  AND p.Total BETWEEN 1200.00 AND 1210.00
GROUP BY p.IdCliente
ORDER BY Importe DESC;

SET STATISTICS IO OFF;
SET STATISTICS TIME OFF;
Activa Include Actual Execution Plan con Ctrl+M, ejecuta la consulta y conserva tanto la pestaña Execution plan como Messages.
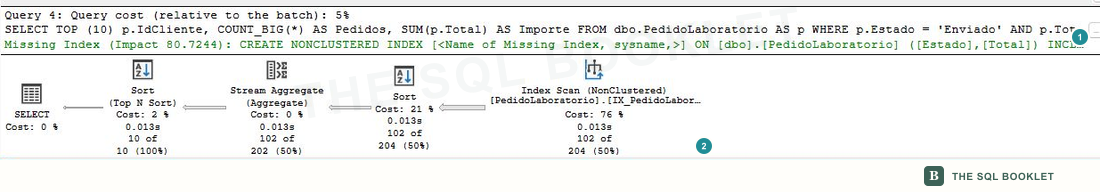
- 1Hipótesis automática
La línea verde vuelve a proponer una clave por
EstadoyTotal. - 2Acceso ejecutado
El plan disponible recorre el índice actual mediante
Index Scan.
La línea base registra 482 lecturas lógicas sobre PedidoLaboratorio. Una lectura lógica representa una página de 8 KB solicitada desde la caché de datos; no equivale a una fila ni implica por sí sola una lectura física en disco.
Crear un candidato deliberado
La instrucción se ejecuta únicamente donde sea seguro crear y eliminar estructuras de prueba:
CREATE NONCLUSTERED INDEX IX_PedidoLaboratorio_Estado_Total
ON dbo.PedidoLaboratorio (Estado, Total)
INCLUDE (IdCliente);
La clave coloca primero la igualdad sobre Estado y después el rango sobre Total. IdCliente permanece como columna incluida porque la consulta lo necesita para agrupar y devolver el resultado, pero no para localizar el intervalo.
Después de crear el candidato, vuelve a consultar su definición y su tamaño:
SELECT
    i.name AS Indice,
    ic.key_ordinal AS OrdenClave,
    ic.is_included_column AS EsIncluida,
    c.name AS Columna,
    sz.PaginasUsadas,
    CONVERT(DECIMAL(12, 2), sz.PaginasUsadas * 8.0 / 1024.0) AS TamanoMB
FROM sys.indexes AS i
INNER JOIN sys.index_columns AS ic
    ON ic.object_id = i.object_id
   AND ic.index_id = i.index_id
INNER JOIN sys.columns AS c
    ON c.object_id = ic.object_id
   AND c.column_id = ic.column_id
CROSS APPLY
(
    SELECT SUM(ps.used_page_count) AS PaginasUsadas
    FROM sys.dm_db_partition_stats AS ps
    WHERE ps.object_id = i.object_id
      AND ps.index_id = i.index_id
) AS sz
WHERE i.object_id = OBJECT_ID(N'dbo.PedidoLaboratorio')
  AND i.name = N'IX_PedidoLaboratorio_Estado_Total'
ORDER BY
    ic.is_included_column,
    ic.key_ordinal,
    ic.index_column_id;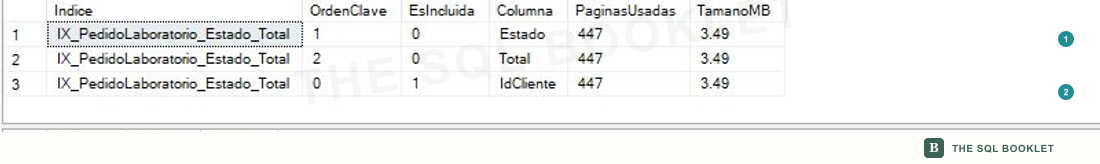
- 1Clave recorrible
Estadoocupa el orden 1 yTotalel orden 2. - 2Costo de espacio
La estructura de prueba ocupa 447 páginas, aproximadamente 3.49 MB, e incluye
IdCliente.
El tamaño no es un dato decorativo. Cada índice adicional necesita almacenamiento, memoria cuando sus páginas entran en caché y mantenimiento cuando una escritura afecta sus columnas.
Repetir la consulta sin cambiar sus condiciones
Ejecuta de nuevo la misma consulta con SET STATISTICS IO, SET STATISTICS TIME y el plan real activados. No cambies los valores, la proyección, el agrupamiento ni el ordenamiento entre ambas mediciones.
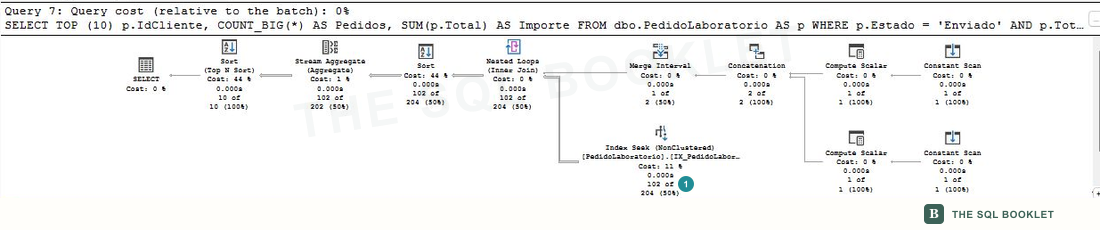
- 1Nuevo acceso
El plan utiliza un
Index Seeksobre el candidato para localizar el estado y el intervalo de totales.
El resto del árbol no desaparece: la consulta todavía agrupa, suma y ordena. El cambio atiende el acceso a las filas; no reemplaza el trabajo que exige producir el resultado final.
Comparar lecturas y conservar el resultado
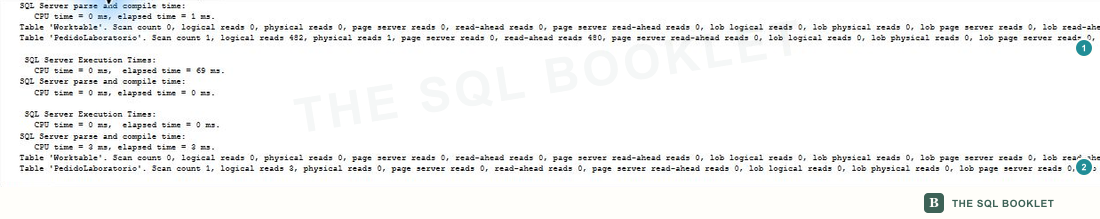
- 1Antes
La consulta registra 482 lecturas lógicas sobre la tabla.
- 2Después
La misma consulta registra 3 lecturas lógicas con el candidato disponible.
Los dos resultados devuelven los mismos clientes, cantidades e importes. Esa igualdad es parte de la prueba: una alternativa que cambia el resultado no es una optimización equivalente.
La reducción de lecturas demuestra un beneficio para esta consulta y estos valores. Los tiempos de una ejecución aislada no se convierten en un porcentaje de mejora: pueden variar por caché, compilación, actividad concurrente y resolución del reloj.
Observar uso y mantenimiento durante la prueba
sys.dm_db_index_usage_stats permite separar búsquedas, escaneos, búsquedas de clave y operaciones de mantenimiento observadas desde el último reinicio de sus contadores:
SELECT
    i.name AS Indice,
    COALESCE(ius.user_seeks, 0) AS Busquedas,
    COALESCE(ius.user_scans, 0) AS Escaneos,
    COALESCE(ius.user_lookups, 0) AS BusquedasClave,
    COALESCE(ius.user_updates, 0) AS OperacionesMantenimiento,
    ius.last_user_seek AS UltimaBusqueda
FROM sys.indexes AS i
LEFT JOIN sys.dm_db_index_usage_stats AS ius
    ON ius.database_id = DB_ID()
   AND ius.object_id = i.object_id
   AND ius.index_id = i.index_id
WHERE i.object_id = OBJECT_ID(N'dbo.PedidoLaboratorio')
  AND i.name = N'IX_PedidoLaboratorio_Estado_Total';
- 1Ventana corta
El candidato registra una búsqueda y ninguna operación de mantenimiento durante esta prueba.
user_updates cuenta operaciones que requirieron mantenimiento del índice; no cuenta filas modificadas. Un valor de cero aquí solo indica que no hubo escrituras durante la existencia breve del candidato. No demuestra que el índice sea gratuito para una carga con INSERT, UPDATE o DELETE.
Decidir entre rechazar, combinar o probar
- Rechazar: cuando la consulta no es relevante, la mejora no aparece al medir, el espacio o la escritura agregados no se justifican, o la sugerencia depende de una observación excepcional.
- Combinar: cuando un índice existente puede atender varias consultas mediante un ajuste comprobado, sin crear estructuras casi duplicadas. Cambiar un índice actual también exige revisar a todos sus consumidores.
- Probar: cuando existe una hipótesis concreta, una línea base repetible, una consulta representativa, un entorno seguro y una restauración definida.
En esta prueba, el candidato merece investigación adicional porque reduce lecturas y conserva el resultado. Todavía faltan parámetros distintos, escrituras, otras consultas, almacenamiento a mayor escala, bloqueo y estabilidad de planes antes de decidir conservarlo en una carga real.
Restaurar el estado inicial
La prueba termina eliminando la estructura temporal:
DROP INDEX IX_PedidoLaboratorio_Estado_Total
ON dbo.PedidoLaboratorio;

SELECT
    CASE WHEN EXISTS
    (
        SELECT 1
        FROM sys.indexes
        WHERE object_id = OBJECT_ID(N'dbo.PedidoLaboratorio')
          AND name = N'IX_PedidoLaboratorio_Estado_Total'
    ) THEN 1 ELSE 0 END AS CandidatoExiste,
    COUNT_BIG(*) AS FilasPedido
FROM dbo.PedidoLaboratorio;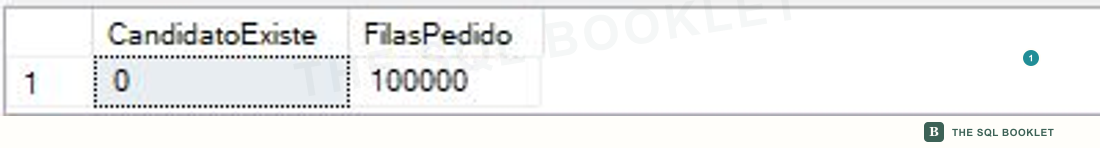
- 1Estado restaurado
CandidatoExiste = 0confirma la eliminación yFilasPedido = 100000conserva el total de la tabla.
La restauración también forma parte de la evidencia. Crear un índice para observarlo y dejarlo activo por omisión convertiría una prueba en un cambio operativo no evaluado.
Siguiente comprobación razonable
La siguiente entrada parte de un síntoma y organiza el recorrido completo: evidencia, plan, señal, explicación posible y prueba controlada. El objetivo será formular una hipótesis comprobable antes de elegir una corrección.
Relacionado con
- Entender el CREATE INDEX generado por SSMS: separa clave, columnas incluidas y decisiones pendientes.
- Leer una sugerencia Missing Index en el plan: identifica el origen de la propuesta.
- Lecturas con SET STATISTICS IO: interpreta las páginas solicitadas durante la ejecución.
- Revisar uso de índices: contrasta lectura y mantenimiento acumulados.
- Revisar sugerencias de índices faltantes: consulta observaciones acumuladas por las DMV.