
De una consulta lenta a una hipótesis comprobable
Una consulta lenta es un síntoma. Para convertirlo en una investigación útil hay que conservar la consulta, reunir evidencia y escribir una explicación que pueda fallar. La primera señal del plan no es todavía la causa.
Conservar la consulta que produjo el síntoma
La consulta resume los pedidos de un día por estado:
DECLARE @FechaObjetivo DATE = '2025-12-30';

SET STATISTICS IO ON;
SET STATISTICS TIME ON;

SELECT
    p.Estado,
    COUNT_BIG(*) AS Pedidos,
    SUM(p.Total) AS ImporteTotal
FROM dbo.PedidoLaboratorio AS p
WHERE YEAR(p.FechaPedido) = YEAR(@FechaObjetivo)
  AND MONTH(p.FechaPedido) = MONTH(@FechaObjetivo)
  AND DAY(p.FechaPedido) = DAY(@FechaObjetivo)
GROUP BY p.Estado
ORDER BY ImporteTotal DESC;

SET STATISTICS IO OFF;
SET STATISTICS TIME OFF;
Activa Include Actual Execution Plan con Ctrl+M antes de ejecutarla. Conserva juntas las pestañas Results, Messages y Execution plan: cada una responde una pregunta distinta.
- Results: qué devolvió la consulta.
- Messages: cuánto trabajo de lectura y tiempo registró esa ejecución.
- Execution plan: qué operadores ejecutó SQL Server y cuántas filas circularon por ellos.
Confirmar primero el resultado

- 1Resultado de referencia
La fecha devuelve 68 pedidos enviados y 68 pendientes. Estos valores deben mantenerse en cualquier alternativa equivalente.
El resultado correcto no demuestra que el acceso sea eficiente. Sí establece una condición que ninguna propuesta puede romper: una variante que cambia cantidades o importes resuelve otra consulta.
Reunir evidencia del trabajo
- 1Trabajo de lectura
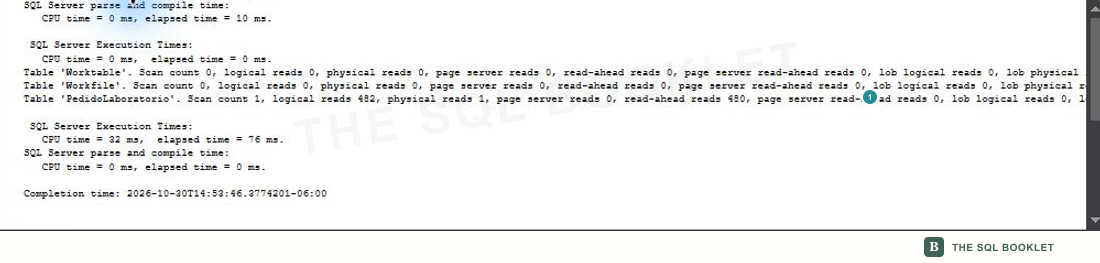
PedidoLaboratorioregistra 482 lecturas lógicas para esta ejecución.
Una lectura lógica es una página de 8 KB solicitada desde la caché de datos. No representa una fila y no implica por sí sola una lectura física. El valor sirve como línea base de esta consulta y estos parámetros.
La misma ejecución registró 32 ms de CPU y 76 ms transcurridos. Un solo tiempo no forma una tendencia: puede cambiar por caché, compilación, actividad concurrente y resolución del reloj. Por eso la hipótesis se apoya también en lecturas, filas y operadores.
Recorrer el plan y elegir una señal
- 1Acceso a los datos
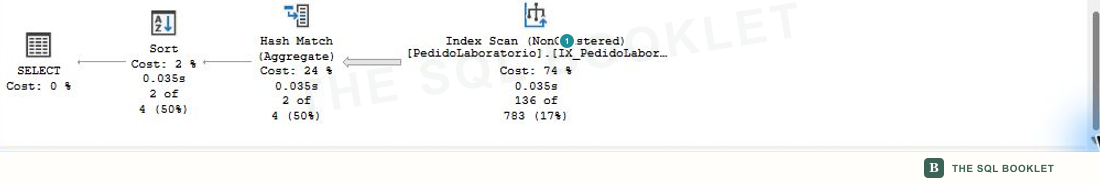
El árbol comienza con un
Index Scansobre el índice cuya clave esFechaPedido.
El árbol también contiene un Hash Match (Aggregate) para formar los grupos y un Sort para ordenar los importes. Esos operadores responden a lo que pide la consulta. La señal elegida para investigar es el acceso inicial porque la consulta filtra por la misma columna que encabeza el índice y, aun así, el plan la recorre como un Scan.
Un Index Scan recorre páginas de un índice y evalúa las filas que encuentra. No es un error por definición: puede ser la opción adecuada cuando se necesita una parte amplia de la estructura. Aquí interesa porque la fecha solicitada representa una fracción pequeña de la tabla.
Abrir las propiedades antes de explicar
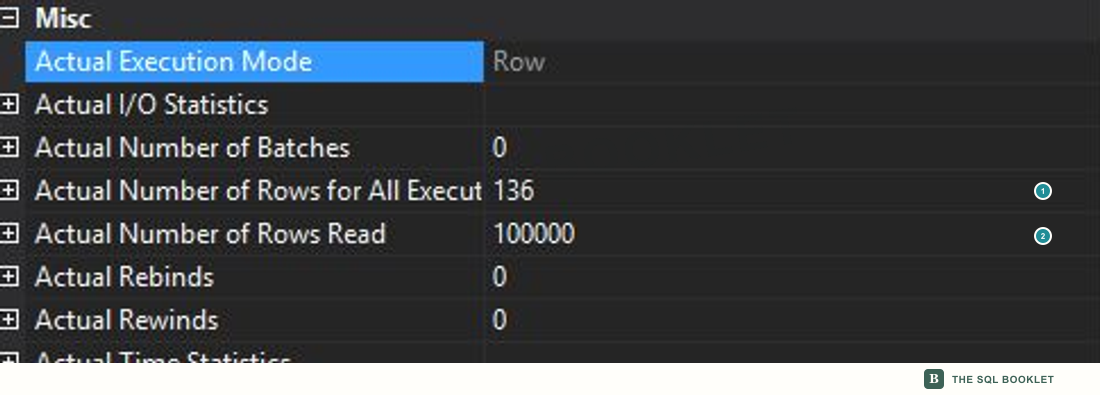
Selecciona el Index Scan y presiona F4. Las propiedades del operador separan las filas que examinó de las que entregó al siguiente nodo.
- 1Filas entregadas
Actual Number of Rows for All Executions = 136: son las filas que cumplen el día solicitado. - 2Filas examinadas
Actual Number of Rows Read = 100000: el operador revisó toda la estructura antes de entregar esas 136 filas.
La diferencia no prueba por sí sola por qué ocurrió el recorrido. Sí delimita el problema: el operador lee muchas más filas de las que aporta al resto del plan.
- 1Condición aplicada durante el recorrido
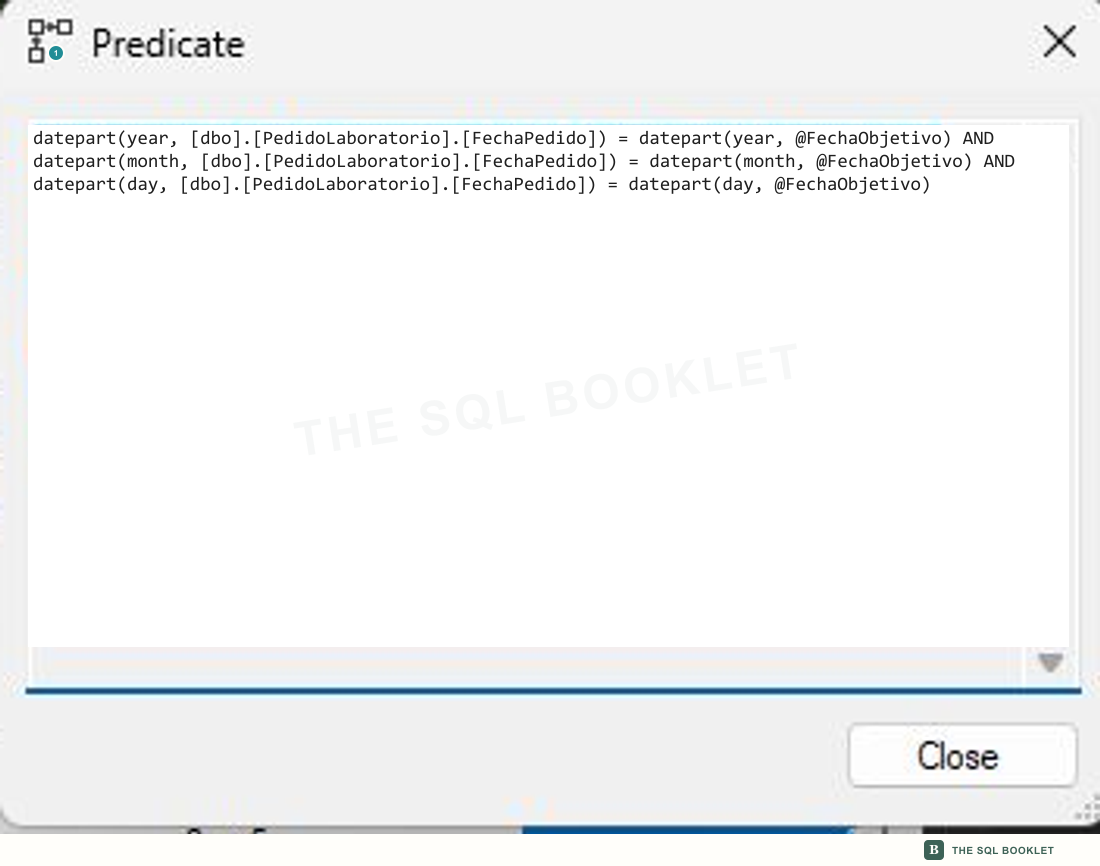
SSMS muestra tres comparaciones con
datepart, correspondientes aYEAR,MONTHyDAY.
El predicado es la condición que decide qué filas atraviesan el operador. Aquí transforma FechaPedido antes de compararla; la captura conserva la ventana real de SSMS y sustituye únicamente el nombre interno de la base.
Separar observación e hipótesis
Las observaciones pueden verificarse directamente:
- el resultado contiene 136 pedidos, repartidos en 68 y 68;
- la consulta registra 482 lecturas lógicas;
- el acceso es un
Index Scan; - el operador lee 100,000 filas y entrega 136;
- el predicado aplica funciones a
FechaPedido.
La explicación provisional es distinta:
Aplicar
YEAR,MONTHyDAYsobre la columna impide que SQL Server convierta la condición en un intervalo directo sobre la claveFechaPedido; por eso recorre el índice y evalúa cada fila.
Esta explicación es una hipótesis, no una causa confirmada. Para que sea comprobable necesita una predicción y una forma de refutarla.
Escribir una predicción que pueda fallar
La alternativa candidata expresa el mismo día como un intervalo semiabierto:
WHERE p.FechaPedido >= @FechaObjetivo
  AND p.FechaPedido < DATEADD(DAY, 1, @FechaObjetivo)
Un intervalo semiabierto incluye el límite inicial y excluye el siguiente. Así conserva cualquier hora del día elegido sin depender de que FechaPedido termine a medianoche.
La predicción es concreta: si las funciones sobre la columna explican el recorrido, el intervalo debe conservar el resultado y reducir las filas y páginas leídas mediante un acceso más directo. La hipótesis pierde apoyo si el resultado cambia, si el operador continúa leyendo una proporción semejante de la tabla o si la reducción no se repite con otras fechas.
Definir la prueba sin ejecutarla todavía
La comparación de la siguiente entrada conservará:
- la misma proyección, agrupación y ordenamiento;
- las mismas fechas para ambas variantes;
- el plan real,
SET STATISTICS IOySET STATISTICS TIME; - una ejecución de calentamiento y varias ejecuciones medidas;
- resultados, lecturas lógicas, filas leídas, plan, CPU y duración;
- el mismo estado de índices y datos durante cada par.
Solo cambiará la forma del predicado. Esa restricción permite relacionar la diferencia observada con una modificación concreta, sin confundirla con otro índice, otros datos o una consulta distinta.
Siguiente comprobación razonable
La siguiente entrada ejecutará la prueba con varias fechas y comparará las distribuciones observadas. El objetivo no será ganar una sola ejecución, sino decidir si la evidencia sostiene la hipótesis sin cambiar el resultado.
Relacionado con
- Construir una línea base repetible: conserva contexto, consulta y medidas antes de comparar.
- Lecturas con SET STATISTICS IO: interpreta las páginas solicitadas durante la ejecución.
- Filas estimadas y filas reales: distingue predicción y trabajo observado.
- Index Seek, Index Scan y Table Scan: reconoce las formas de acceso a las filas.