
Spool: materialización y reutilización
Algunas ramas producen filas que otro operador podría solicitar varias veces. SQL Server puede conservar ese resultado intermedio en una estructura de trabajo y volver a leerlo en lugar de reconstruirlo siempre desde su origen.
La familia Spool representa esa decisión. Su presencia no demuestra desperdicio: debemos identificar qué conserva, cómo lo construye y cuántas veces lo reutiliza.
Materializar un resultado intermedio
Materializar significa almacenar las filas producidas por una rama para consultarlas de nuevo. La estructura puede utilizar memoria y páginas internas de tempdb, la base de datos del sistema destinada también a objetos y trabajo temporal.
Eso no significa que cada spool haya escrito físicamente al disco. Tampoco indica que las filas deban convertirse en una tabla permanente. El alcance pertenece al plan y a su ejecución.
Una consulta que reutiliza filas
La prueba crea dos tablas temporales. #PedidoSpool no tiene un índice por IdCliente; la unión mediante ciclos permite observar una estructura intermedia que evita reiniciar la lectura completa para cada cliente.
Ejecuta la preparación y la consulta en la misma ventana de SSMS. Activa antes Include Actual Execution Plan con Ctrl+M; al terminar abre Execution plan. Localiza Table Spool o Index Spool, selecciónalo y presiona F4 para revisar Actual Rebinds, Actual Rewinds, Number of Executions y el objeto de trabajo. Si se ejecuta solamente el SELECT en otra conexión, las tablas temporales no existirán.
CREATE TABLE #ClienteSpool
(
    IdCliente INT NOT NULL,
    CONSTRAINT PK_ClienteSpool
        PRIMARY KEY CLUSTERED (IdCliente)
);

CREATE TABLE #PedidoSpool
(
    IdPedido  INT NOT NULL,
    IdCliente INT NOT NULL,
    Total     DECIMAL(12, 2) NOT NULL
);

INSERT INTO #ClienteSpool (IdCliente)
SELECT DISTINCT p.IdCliente
FROM dbo.PedidoLaboratorio AS p;

INSERT INTO #PedidoSpool (IdPedido, IdCliente, Total)
SELECT
    p.IdPedido,
    p.IdCliente,
    p.Total
FROM dbo.PedidoLaboratorio AS p;

SELECT COUNT_BIG(*) AS Coincidencias
FROM #ClienteSpool AS c
INNER LOOP JOIN #PedidoSpool AS p
    ON p.IdCliente = c.IdCliente
WHERE c.IdCliente BETWEEN 1 AND 200
OPTION (MAXDOP 1, RECOMPILE);

SELECT
    c.IdCliente,
    x.IdPedido,
    x.Total
FROM #ClienteSpool AS c
OUTER APPLY
(
    SELECT TOP (1)
        p.IdPedido,
        p.Total
    FROM #PedidoSpool AS p
    WHERE p.IdCliente = c.IdCliente
    ORDER BY
        p.Total DESC,
        p.IdPedido
) AS x
WHERE c.IdCliente BETWEEN 1 AND 200
OPTION (MAXDOP 1, RECOMPILE);

DROP TABLE #PedidoSpool;
DROP TABLE #ClienteSpool;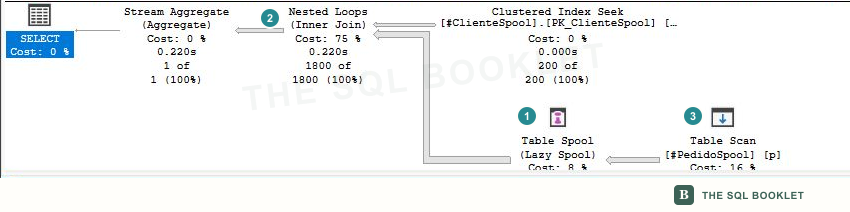
- 1Resultado conservado
Table Spool (Lazy Spool)almacena filas conforme el operador consumidor las solicita. - 2Operador consumidor
Nested Loopsvuelve a pedir coincidencias para cada fila que recibe desde su entrada externa. - 3Entrada del spool
Table Scanlee las filas que el spool conserva para las solicitudes posteriores.
La rama que alimenta el spool comienza con un Table Scan sobre la tabla temporal. Nested Loops vuelve a solicitar coincidencias para distintas filas externas; el spool conserva el trabajo disponible para esas solicitudes.
INNER LOOP JOIN se usa para aislar el mecanismo durante la prueba. No constituye una recomendación para forzar la estrategia en una aplicación.
Table Spool e Index Spool
Table Spool conserva filas sin construir una llave de búsqueda propia. El consumidor puede volver a recorrer el resultado guardado.
Index Spool agrega un índice temporal sobre las filas materializadas. Esa llave permite localizar subconjuntos sin recorrer toda la estructura cada vez.
El nombre del operador distingue ambas estructuras. Después revisamos Seek Predicates, Output List y la relación con el consumidor para conocer cómo se consulta el resultado conservado.
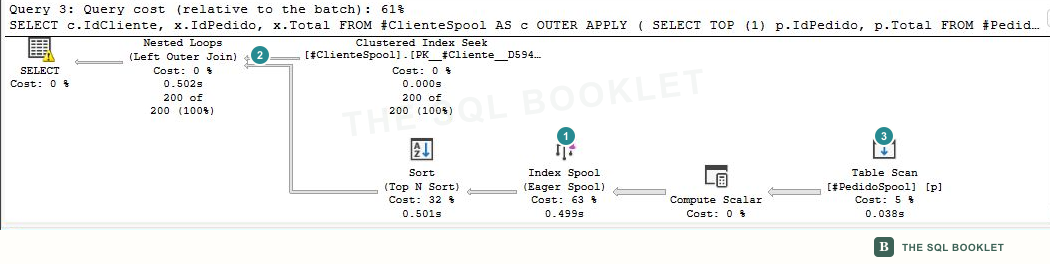
- 1Estructura con llave temporal
Index Spool (Eager Spool)construye una estructura indexada para localizar las filas solicitadas por la correlación deIdCliente. - 2Operador consumidor
Nested Loopsrecibe cada cliente y solicita la rama interna que produce su pedido de mayor importe. - 3Entrada materializada
Table Scanrecorre la tabla temporal que alimenta la construcción del índice de trabajo.
Construcción Eager y Lazy
Eager Spool consume su entrada y llena la estructura antes de entregar la primera fila solicitada. Eager describe esa construcción anticipada.
Lazy Spool almacena filas conforme el consumidor las pide. Lazy describe una construcción gradual, no la ausencia de trabajo.
Ambos pueden reutilizar datos. La diferencia indica cuándo construyen la estructura respecto de la primera fila que entregan.
En el segundo plan, la etiqueta completa reúne ambas decisiones: Index Spool indica la estructura con llave y Eager Spool indica que se llena antes de entregar la primera fila. En el primer plan, Table Spool (Lazy Spool) conserva filas de manera gradual.
Rebind y Rewind
Un rebind reinicia el operador porque cambiaron los valores con los que debe trabajar. La estructura puede necesitar otra construcción para el nuevo contexto.
Un rewind vuelve a leer las filas conservadas sin reconstruirlas para valores nuevos. Los contadores Actual Rebinds y Actual Rewinds se interpretan junto con Number of Executions y con la rama consumidora.
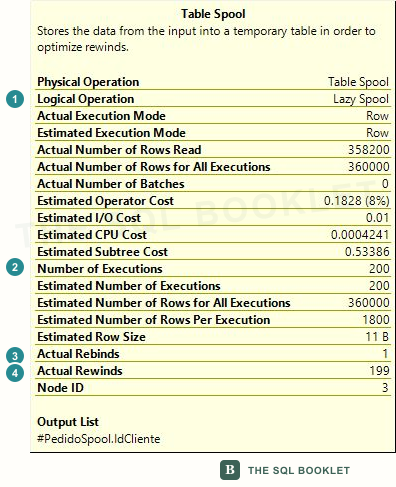
- 1Tipo de construcción
Logical Operationidentifica este operador comoLazy Spool. - 2Ejecuciones
Number of Executionsregistra 200 solicitudes al operador. - 3Primer contexto
Actual Rebindsregistra una construcción para los valores iniciales. - 4Reutilizaciones
Actual Rewindsregistra 199 lecturas que volvieron al resultado conservado.
Un valor alto no constituye por sí solo un defecto. Primero comprobamos cuántas filas contiene cada reutilización y qué trabajo evita o agrega.
Por qué puede aparecer
Un spool puede:
- evitar que una rama costosa se produzca repetidamente;
- ofrecer una llave temporal que no existe en la entrada;
- preservar filas necesarias para mantener la corrección de una modificación;
- sostener el estado requerido por una ventana u otro operador.
Estas finalidades no son equivalentes. Las propiedades, el operador consumidor y el SQL permiten distinguirlas.
Qué conclusión todavía no permite obtener
Retirar Spool del dibujo no garantiza menos trabajo. Una reescritura puede obligar a repetir lecturas; un índice nuevo puede trasladar el costo a todas las escrituras; y un hint puede impedir una alternativa que resultaba conveniente con otros parámetros.
Antes de cambiar la consulta medimos ejecuciones, filas, lecturas, memoria y duración. También comprobamos si la estructura se reconstruye o se reutiliza y si su propósito protege la corrección.
Siguiente comprobación razonable
Continúa con Parallelism: distribuir, repartir y reunir filas para reconocer estructuras que coordinan varios trabajadores.