
Stream Aggregate y Hash Match (Aggregate)
GROUP BY expresa que varias filas deben convertirse en un resultado por grupo. El plan todavía debe elegir cómo mantener esos grupos mientras calcula COUNT, SUM u otra agregación.
Dos mecanismos frecuentes son Stream Aggregate, que aprovecha una entrada ordenada, y Hash Match (Aggregate), que construye grupos mediante una tabla hash.
Cómo abrir y distinguir ambos planes
Activa Include Actual Execution Plan con Ctrl+M y ejecuta cada consulta por separado. En Execution plan, localiza el operador cuyo nombre completo termina en (Aggregate). Coloca el puntero sobre él o selecciónalo y presiona F4 para comprobar Physical Operation, Logical Operation, las filas recibidas y las filas entregadas.
Las cuadrículas de Results muestran los grupos calculados; las capturas de esta entrada pertenecen a Execution plan. Los hints ORDER GROUP y HASH GROUP se usan aquí para aislar los mecanismos, no para recomendar que se impongan en una consulta de aplicación.
Agregar significa reducir filas por grupo
Una agregación combina filas y produce un valor resumido. La llave de agrupación contiene las columnas que deciden qué filas pertenecen al mismo grupo.
Los dos operadores de esta entrada realizan ese propósito lógico, pero requieren estructuras diferentes. El nombre físico permite reconstruir qué estrategia eligió SQL Server.
Stream Aggregate: aprovechar el orden
Stream Aggregate recibe filas ordenadas por la llave de agrupación. Mientras la llave permanece igual, acumula el grupo actual; cuando cambia, entrega el resultado y comienza el siguiente.
SELECT
    p.FechaPedido,
    COUNT_BIG(*) AS Pedidos,
    SUM(p.Total) AS TotalAcumulado
FROM dbo.PedidoLaboratorio AS p
GROUP BY p.FechaPedido
OPTION (ORDER GROUP, MAXDOP 1, RECOMPILE);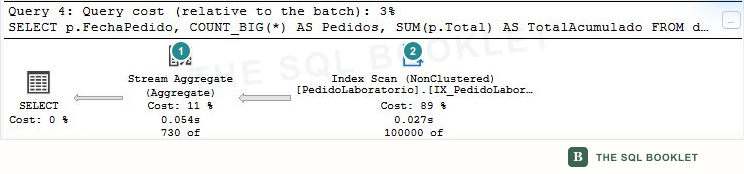
- 1Agregación continua
Stream Aggregaterecibe 100,000 filas y entrega 730 grupos, uno por fecha. - 2Orden disponible
El
Index Scanrecorre un índice cuya llave comienza conFechaPedido; la entrada ya llega en el orden necesario.
Un Index Scan puede leer muchas filas y conservar el orden de la llave del índice. La propiedad Ordered de la entrada y Group By del agregado permiten comprobar la relación. Si el orden no existe, el plan puede producirlo mediante Sort o elegir otra estrategia.
Hash Match (Aggregate): construir grupos por llave
Hash Match (Aggregate) calcula una función hash sobre la llave y utiliza el resultado para localizar el grupo donde acumulará cada fila.
Una función hash transforma una llave en un valor que la dirige a una sección de una estructura. Las coincidencias se confirman con la llave original; el hash organiza la búsqueda, no sustituye la comparación.
SELECT
    p.Estado,
    COUNT_BIG(*) AS Pedidos,
    SUM(p.Total) AS TotalAcumulado
FROM dbo.PedidoLaboratorio AS p
GROUP BY p.Estado
OPTION (HASH GROUP, MAXDOP 1, RECOMPILE);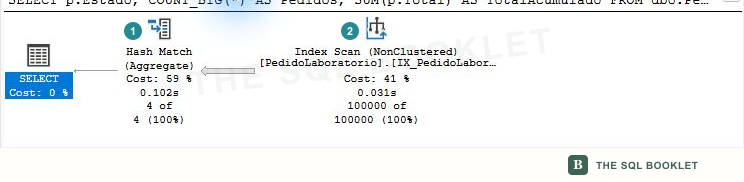
- 1Tabla hash de grupos
Hash Match (Aggregate)recibe 100,000 filas y entrega cuatro estados. - 2Entrada sin orden requerido
El
Index Scanaporta las filas; el agregado no depende de que estén ordenadas porEstado.
La tabla hash requiere memoria. Si la concesión resulta insuficiente, el operador puede dividir el trabajo y utilizar tempdb. El nombre Hash Match no demuestra un derrame: necesitamos una advertencia y las propiedades de la ejecución observada.
Comparar mecanismos sin declarar un ganador
| Operador | Necesita | Conviene comprobar |
|---|---|---|
Stream Aggregate |
Entrada ordenada por la llave del grupo | De dónde proviene el orden y si requiere Sort |
Hash Match (Aggregate) |
Memoria para mantener la tabla hash | Filas, concesión y advertencias de derrame |
Stream Aggregate no es siempre mejor por parecer más sencillo. Si necesita ordenar un conjunto amplio, ese trabajo forma parte de la estrategia. Hash Match (Aggregate) no es siempre peor por solicitar memoria; puede evitar producir un orden que no existe.
Los hints ORDER GROUP y HASH GROUP se utilizan aquí para aislar ambos mecanismos. OPTION y los query hints` explica por qué no deben conservarse automáticamente en una consulta real.
Qué conclusión todavía no permite obtener
El operador elegido no demuestra por sí solo que una agrupación sea eficiente. Todavía necesitamos medir lecturas, memoria, duración, filas y frecuencia, además de comprobar si el orden o el hash provocaron trabajo adicional.
Tampoco conviene crear un índice solo para retirar un icono. La estructura debe evaluarse contra las demás consultas y contra su costo de almacenamiento y mantenimiento.
Siguiente comprobación razonable
Continúa con Spool: materialización y reutilización para reconocer cuándo el plan conserva un resultado intermedio.