
Parallelism: distribuir, repartir y reunir filas
Un plan serial realiza el trabajo mediante un solo flujo. Un plan paralelo puede dividir una parte entre varios trabajadores y después coordinar las filas que cada uno produce.
Los operadores Parallelism representan los puntos donde cambia esa organización. No ejecutan por sí solos toda la consulta: distribuyen, redistribuyen o reúnen flujos para que otros operadores trabajen con ellos.
Trabajadores y flujos
Un trabajador es la unidad que ejecuta una tarea asignada por SQL Server. El grado de paralelismo, o DOP, indica cuántos trabajadores pueden participar en una zona paralela; no equivale al número total de operadores ni garantiza que todos reciban la misma cantidad de filas.
Una zona paralela es un tramo del plan donde varios trabajadores pueden procesar filas simultáneamente. Los operadores de intercambio marcan cómo entran, cambian de distribución o salen esas filas.
Tres intercambios frecuentes
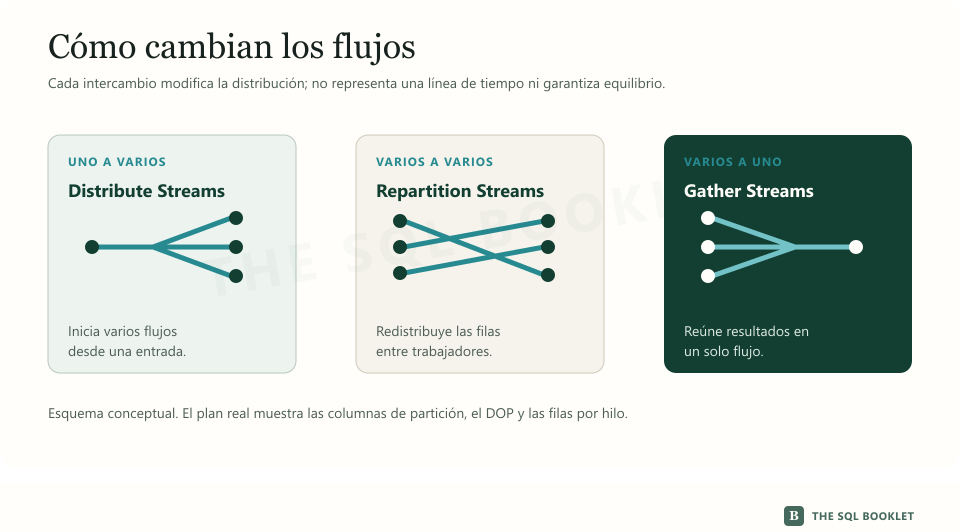
Un flujo  -- Distribute Streams -->  varios flujos
Varios    -- Repartition Streams ->  varios flujos redistribuidos
Varios    -- Gather Streams ------>  un flujo
El esquema describe cardinalidad de flujos, no orden temporal ni velocidad. Cada intercambio conserva las columnas de las filas, pero puede cambiar qué trabajador recibe cada una y si el orden continúa disponible.
Distribute Streams: iniciar varios flujos
Distribute Streams recibe un flujo y produce varios. Cada fila se dirige a uno de los flujos de salida, salvo estrategias específicas como una distribución por difusión.
La propiedad Partitioning Type indica el criterio utilizado. Si aparece Hash, Partition Columns muestra las columnas con las que se calcula el destino. La distribución intenta preparar trabajo para varios consumidores; todavía debemos comprobar si las filas quedaron equilibradas.
Repartition Streams: cambiar la distribución
Repartition Streams recibe varios flujos y vuelve a asignar cada fila a un flujo de salida. Suele aparecer cuando el siguiente operador necesita que las filas con una misma llave lleguen al mismo trabajador.
Por ejemplo, una unión o agregación hash puede requerir una partición compatible con su llave. La redistribución permite esa correspondencia, pero también introduce coordinación y movimiento de filas.
Si una llave concentra muchos valores en una sola partición, un trabajador puede recibir bastante más trabajo que los demás. Esa diferencia se denomina sesgo. Se comprueba comparando filas por hilo; no se deduce únicamente por la presencia del operador.
Gather Streams: volver a un solo flujo
Gather Streams consume varios flujos y produce uno. Suele cerrar una zona paralela antes de que el operador raíz entregue el resultado.
Cuando necesita conservar un orden, sus propiedades incluyen las columnas correspondientes y los flujos de entrada deben poder combinarse en ese orden. Si no existe ese requisito, reúne las filas sin prometer una secuencia de presentación.
Gather Streams no significa que el trabajo anterior fue inútil. Muestra el punto donde varios resultados parciales deben coordinarse para continuar como un solo flujo.
Cómo reconocer la zona paralela
En el plan gráfico, algunos operadores muestran dos flechas pequeñas sobre el icono cuando participaron en una zona paralela. En las propiedades podemos revisar Parallel, Actual Number of Rows for All Executions, información por hilo y el grado de paralelismo observado.
El plan XML contiene los mismos intercambios y permite distinguir su operación lógica. Si el optimizador conserva un plan serial, NonParallelPlanReason puede registrar una razón, como una edición sin planes paralelos, MAXDOP 1 o una condición de la consulta.
MAXDOP establece un límite
MAXDOP limita el grado de paralelismo disponible para una consulta; no obliga al optimizador a elegir un plan paralelo. Aun con MAXDOP 4, una consulta puede conservar un plan serial si el motor no considera conveniente o posible una alternativa paralela.
El umbral de costo, la edición, los procesadores disponibles, las estructuras de la consulta y otras configuraciones participan en la decisión. Cambiar una configuración para conseguir un icono no constituye una prueba de mejora.
Qué revisar en el plan
| Señal | Pregunta |
|---|---|
| Tipo de intercambio | ¿El flujo se distribuye, se redistribuye o se reúne? |
| Columnas de partición | ¿Qué llave decide el trabajador de destino? |
| Filas por hilo | ¿El trabajo quedó equilibrado o existe sesgo? |
| Orden | ¿El intercambio conserva o pierde una secuencia necesaria? |
| DOP y ejecuciones | ¿Cuántos trabajadores participaron realmente? |
Las esperas también aportan contexto. Una espera relacionada con intercambio puede representar coordinación normal o un desequilibrio; necesita relacionarse con duración, CPU, filas por hilo y comportamiento repetido.
Qué conclusión todavía no permite obtener
Un plan paralelo no es automáticamente más rápido y un plan serial no es automáticamente insuficiente. Dividir trabajo agrega coordinación y puede aumentar CPU total aunque reduzca la duración; también puede dejar un trabajador dominante si la distribución está sesgada.
La evaluación necesita una línea base, varias ejecuciones y condiciones comparables. MAXDOP se trata como una decisión de carga y entorno, no como una corrección universal de una consulta aislada.
Siguiente comprobación razonable
Continúa con Advertencias del plan que requieren investigación para separar una señal visible de una causa todavía pendiente de comprobar.