
Key Lookup y trabajo repetido
Un índice puede localizar las filas solicitadas sin contener todas las columnas que necesita la consulta. SQL Server utiliza entonces el localizador guardado en ese índice para volver a la fila completa. El plan representa ese segundo acceso como Key Lookup.
Qué es un Key Lookup
Key es la llave clustered que identifica la fila. Cuando una tabla tiene un índice clustered, sus índices nonclustered conservan esa llave como localizador aunque no aparezca escrita entre sus columnas incluidas.
Lookup es la recuperación de columnas que faltan en el índice utilizado para buscar. SQL Server toma el localizador encontrado en el índice nonclustered, entra al índice clustered y obtiene el resto de la fila.
El Key Lookup aparece normalmente debajo de Nested Loops. Nested Loops recibe una fila del primer acceso y solicita el segundo acceso con la llave de esa fila. Si el primer acceso entrega 90 localizadores, el Key Lookup puede ejecutarse 90 veces.
Qué contiene cada estructura
El ejemplo utiliza una tabla temporal con 100,000 pedidos y dos índices:
PK_PedidoLookupes el índice clustered porIdPedido. Su nivel hoja contiene las filas completas.IX_PedidoLookup_IdClientees un índice nonclustered porIdCliente. También conservaIdPedidocomo localizador, pero no incluyeEstadoniTotal.
La consulta filtra por IdCliente, pero solicita además Estado y Total.
IF OBJECT_ID(N'tempdb..#PedidoLookup', N'U') IS NOT NULL
    DROP TABLE #PedidoLookup;

CREATE TABLE #PedidoLookup
(
    IdPedido  INT NOT NULL,
    IdCliente INT NOT NULL,
    Estado    VARCHAR(20) NOT NULL,
    Total     DECIMAL(12, 2) NOT NULL,
    CONSTRAINT PK_PedidoLookup
        PRIMARY KEY CLUSTERED (IdPedido)
);

INSERT INTO #PedidoLookup
    (IdPedido, IdCliente, Estado, Total)
SELECT
    p.IdPedido,
    p.IdCliente,
    p.Estado,
    p.Total
FROM dbo.PedidoLaboratorio AS p;

CREATE INDEX IX_PedidoLookup_IdCliente
    ON #PedidoLookup (IdCliente);

DECLARE @ClienteInicial INT = 1;
DECLARE @ClienteFinal INT = 10;

SELECT
    p.IdPedido,
    p.IdCliente,
    p.Estado,
    p.Total
FROM #PedidoLookup AS p
WHERE p.IdCliente BETWEEN @ClienteInicial AND @ClienteFinal
ORDER BY
    p.IdCliente,
    p.IdPedido
OPTION (RECOMPILE);

DROP TABLE #PedidoLookup;
OPTION (RECOMPILE) permite observar el plan compilado para este intervalo. Se utiliza para esta comprobación; no constituye una recomendación general para consultas de aplicación. Consulta OPTION y los query hints para distinguir este recurso de prueba de una decisión que permanecerá en producción.
Ejecuta el bloque completo en una ventana nueva. Antes de hacerlo, activa Include Actual Execution Plan con Ctrl+M. Al terminar, abre Execution plan y localiza la cadena Index Seek → Nested Loops → Key Lookup. La tabla temporal solo existe durante esta conexión y el bloque la elimina al terminar.
Cómo se forma el plan
El plan se lee desde los accesos situados a la derecha hacia el resultado situado a la izquierda.
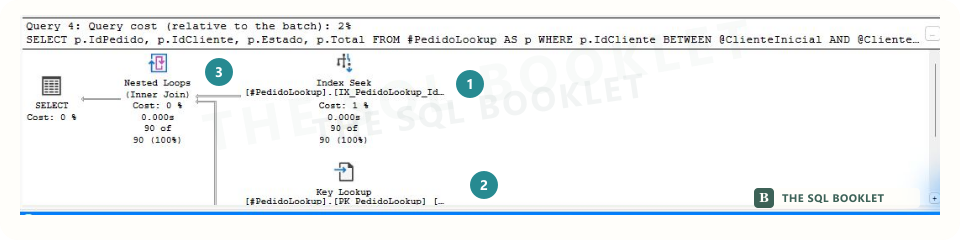
- 1INDEX SEEK
Localiza 90 entradas de IdCliente y entrega el IdPedido que identifica cada fila.
El índice es estrecho: todavía no contiene Estado ni Total.
- 2KEY LOOKUP
Usa cada IdPedido para volver al índice clustered y recuperar Estado y Total.
Una recuperación entrega una fila; en esta ejecución se repite 90 veces.
- 3NESTED LOOPS
Coordina ambos accesos: por cada localizador recibido, solicita una recuperación.
El resultado reúne las columnas encontradas en las dos estructuras.
Index Seek utiliza IX_PedidoLookup_IdCliente para localizar el intervalo de clientes. Entrega 90 filas con IdCliente e IdPedido.
Nested Loops toma cada IdPedido y solicita una recuperación. Key Lookup utiliza esa llave para entrar a PK_PedidoLookup y obtener Estado y Total. El resultado reúne las columnas provenientes de ambos accesos.
La operación no apareció porque SQL Server creara un índice durante la ejecución. Ambos índices ya existían al compilar la consulta. El optimizador combinó el índice estrecho que permite buscar por IdCliente con el índice clustered que contiene la fila completa.
Por qué importa el número de ejecuciones
Un solo Key Lookup recupera una fila. El trabajo acumulado depende de cuántas veces se solicita.
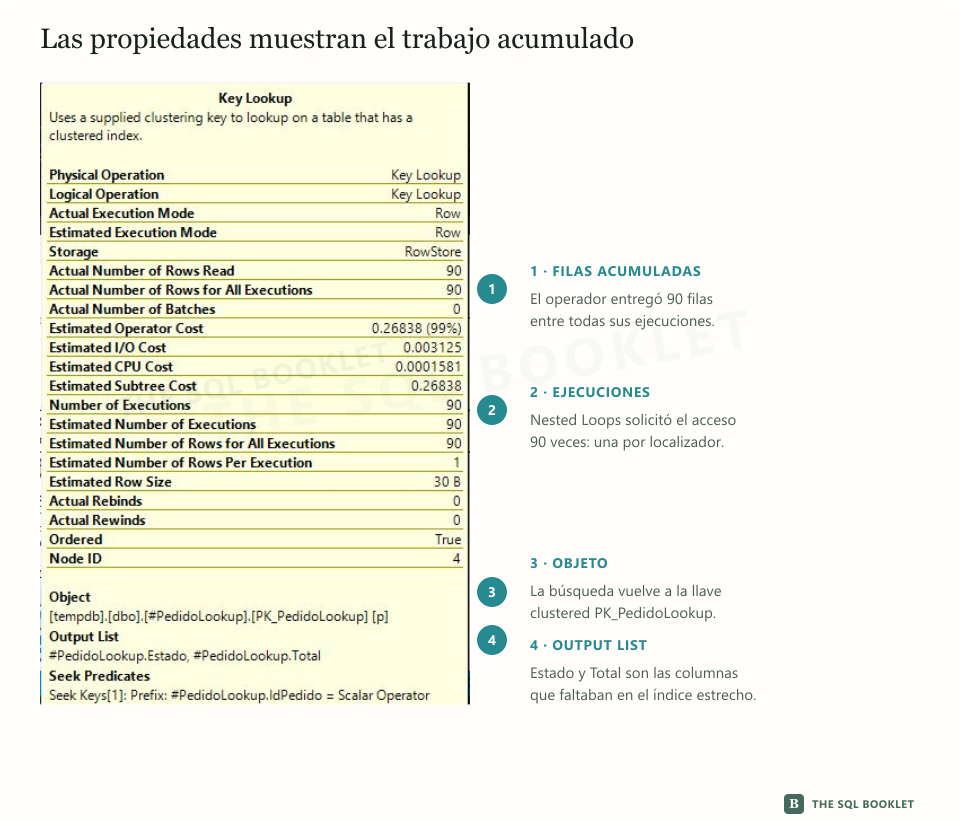
En la ejecución observada:
| Propiedad | Valor | Qué describe |
|---|---|---|
Actual Number of Rows for All Executions |
90 | Filas que entregó el operador entre todas sus ejecuciones. |
Number of Executions |
90 | Veces que Nested Loops solicitó la recuperación. |
Object |
PK_PedidoLookup |
Índice clustered al que regresó el operador. |
Output List |
Estado, Total |
Columnas recuperadas porque no estaban en el primer índice. |
La relación es directa en este caso: 90 localizadores producen 90 ejecuciones y cada ejecución entrega una fila. En otro plan, los valores pueden diferir; las propiedades deben comprobarse en lugar de inferirse por el dibujo.
Cuándo puede ser razonable
Un Key Lookup puede ser una forma eficiente de completar unas cuantas filas. Mantener un índice nonclustered estrecho reduce su tamaño y puede facilitar la búsqueda inicial. Si la consulta aparece poco y devuelve pocos localizadores, el segundo acceso puede costar menos que mantener otra estructura más amplia.
Su presencia no demuestra por sí sola un problema. El nombre del operador describe cómo se obtuvieron las columnas faltantes.
Cuándo merece revisión
El acceso merece una revisión más cercana cuando reúne varias condiciones:
- el primer operador entrega muchas filas;
Number of Executionsmuestra muchas recuperaciones;- la consulta se ejecuta con frecuencia;
- las lecturas, la duración o la CPU aumentan junto con ese patrón;
- la cantidad real de filas supera ampliamente la estimada.
El porcentaje de costo visible en el plan es una estimación relativa dentro de ese plan. No sustituye las mediciones de una ejecución ni permite comparar por sí solo consultas distintas.
Qué significa cubrir la consulta
Un índice cubre una consulta cuando contiene las llaves necesarias para buscar y todas las columnas necesarias para filtrar, relacionar y devolver el resultado. En ese caso, SQL Server puede completar la consulta sin regresar a la fila clustered.
Las columnas agregadas mediante INCLUDE permanecen en el nivel hoja de un índice nonclustered y pueden completar su cobertura sin formar parte de la llave ordenada. Incluir Estado y Total en este índice podría eliminar el Key Lookup para esta forma concreta de la consulta.
Eso no convierte a INCLUDE en una corrección automática. Cada columna amplía el índice, consume almacenamiento y aumenta el trabajo de escritura y mantenimiento. Antes de cambiarlo conviene revisar índices semejantes, frecuencia de la consulta, columnas solicitadas, cantidad de filas y costo de las modificaciones.
Qué comprobar antes de modificar un índice
- Confirma en el plan real cuántas veces se ejecutó el
Key Lookup. - Revisa qué columnas aparecen en
Output List. - Mide lecturas, CPU y duración con una carga representativa.
- Comprueba si ya existe un índice que contiene una llave o cobertura equivalente.
- Considera las operaciones
INSERT,UPDATEyDELETEque deberán mantener una estructura más amplia. - Repite la medición después del cambio y conserva una ruta de reversión.
También puede ser razonable reducir las columnas solicitadas o revisar por qué la consulta recupera tantas filas. La alternativa correcta depende de la necesidad que produjo el plan.
Qué conclusión todavía no permite obtener
El caso demuestra cómo un índice nonclustered estrecho y un índice clustered pueden combinarse mediante Nested Loops. No demuestra que todo Key Lookup deba eliminarse ni que agregar columnas a un índice siempre mejore el sistema.
Para evaluar su impacto necesitamos relacionar ejecuciones, lecturas y frecuencia con la carga completa. Una recuperación repetida puede dominar una consulta; una recuperación ocasional puede ser la opción de menor costo.
Siguiente comprobación razonable
Continúa con Filter, Compute Scalar y Top para reconocer operadores que transforman, limitan o descartan filas antes de seguir el flujo.