
Lecturas con SET STATISTICS IO
El plan muestra la estrategia elegida para resolver una consulta. SET STATISTICS IO agrega otra pieza de evidencia: cuántas páginas leyó SQL Server de cada objeto durante esa ejecución.
Una página es la unidad básica con la que SQL Server organiza datos e índices. Normalmente mide 8 KB. El contador registra accesos a páginas, no filas devueltas ni megabytes transferidos al cliente.
Activar la medición
La opción se habilita para la sesión actual y escribe sus resultados en Messages:
SET STATISTICS IO ON;

DECLARE @Desde DATE = '2025-12-30';

SELECT COUNT_BIG(*) AS Pedidos
FROM dbo.PedidoLaboratorio AS p
WHERE p.FechaPedido >= @Desde;

SET STATISTICS IO OFF;
Ejecuta el bloque completo con F5. SSMS abre Results con el conteo y Messages con las líneas de Table, Scan count, logical reads, physical reads y read-ahead reads. Si también quieres relacionar la medición con su estrategia, activa Include Actual Execution Plan con Ctrl+M antes de ejecutar y abre después Execution plan.
ON permanece activo para las instrucciones posteriores de la misma sesión hasta ejecutar OFF o cerrar la conexión. Conviene desactivarlo al terminar para no mezclar mediciones de consultas distintas.
La salida se organiza por objeto
La prueba compara dos consultas que devuelven el mismo conteo. La primera compara directamente la columna indexada; la segunda transforma esa columna con DATEDIFF.
DECLARE @Desde DATE = '2025-12-30';

SELECT COUNT_BIG(*) AS Pedidos
FROM dbo.PedidoLaboratorio AS p
WHERE p.FechaPedido >= @Desde;

SELECT COUNT_BIG(*) AS Pedidos
FROM dbo.PedidoLaboratorio AS p
WHERE DATEDIFF(DAY, @Desde, p.FechaPedido) >= 0;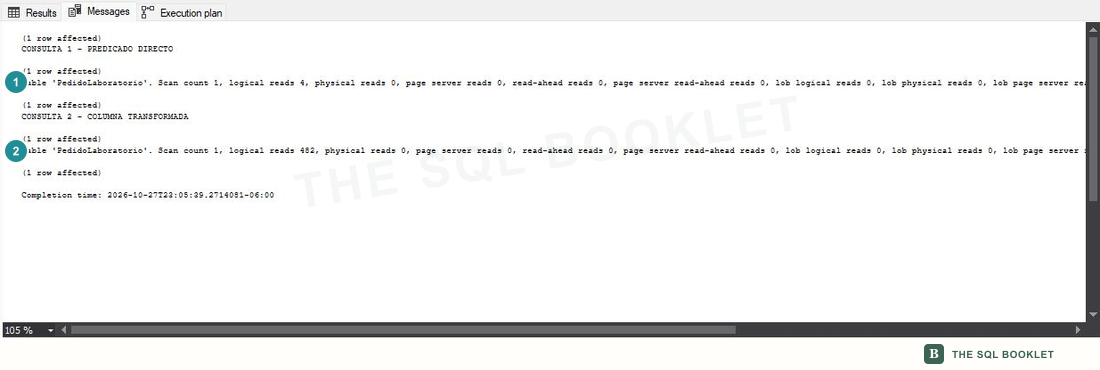
- 1Predicado directo
PedidoLaboratorioregistrascan count 1,logical reads 4yphysical reads 0. - 2Columna transformada
El mismo objeto registra
scan count 1, pero sus lecturas lógicas aumentan a482. Las dos consultas devolvieron136pedidos.
Una consulta puede mostrar varias líneas cuando accede a varias tablas, índices internos o estructuras de trabajo. Cada línea debe relacionarse con el objeto y con la rama correspondiente del plan; no se suman contadores sin entender primero de dónde provienen.
logical reads: páginas obtenidas de la caché
Una lectura lógica ocurre cuando el motor solicita una página al búfer de datos, la memoria donde SQL Server conserva páginas utilizadas recientemente. El contador incluye cada acceso solicitado durante la ejecución, por lo que no representa necesariamente páginas únicas.
En esta prueba, 4 frente a 482 permite afirmar que la segunda estrategia recorrió muchas más páginas del mismo objeto. Todavía no indica cuánto tardó, cuánta CPU consumió ni si esa diferencia es importante para toda la carga de trabajo.
physical reads: páginas que no estaban en memoria
Una lectura física ocurre cuando la página solicitada no estaba disponible en la caché y tuvo que obtenerse del almacenamiento. Ambas consultas muestran physical reads 0: las páginas necesarias ya estaban en memoria durante esta ejecución.
Ese cero no significa que la consulta no hizo trabajo. Las lecturas lógicas siguen presentes. Tampoco conviene vaciar la caché de una instancia compartida solo para forzar lecturas físicas; esa acción altera las condiciones de otras sesiones y no forma parte de esta comprobación.
read-ahead reads: páginas solicitadas por anticipado
La lectura anticipada permite solicitar páginas antes de que el operador llegue a necesitarlas cuando SQL Server prevé un recorrido. En esta prueba el contador fue 0. En otra ejecución puede cambiar por el plan, el tamaño del acceso, la caché y el estado de la instancia.
Los contadores lob logical reads, lob physical reads y lob read-ahead reads corresponden a datos de objetos grandes cuando la consulta los utiliza. Aquí permanecen en cero porque el acceso no necesita columnas LOB.
scan count no nombra al operador
scan count cuenta inicios de acceso al objeto. No cuenta páginas, filas ni veces que aparece la palabra Scan en el plan. Por eso las dos consultas muestran scan count 1 aunque una usa Index Seek y la otra Index Scan.
El valor ayuda a reconocer accesos repetidos, pero necesita contexto. Un acceso puede comenzar una vez y leer muchas páginas; otro puede comenzar muchas veces dentro de Nested Loops y leer pocas en cada ejecución.
Relacionar las lecturas con el plan
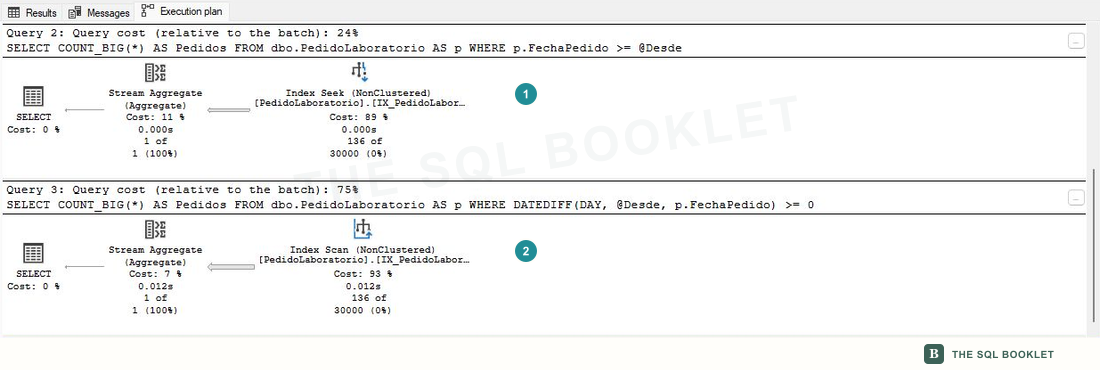
- 1
Index SeekEl predicado directo permite iniciar el acceso en el rango correspondiente de
IX_PedidoLaboratorio_FechaPedido. La medición asociada fue de cuatro lecturas lógicas. - 2
Index ScanDATEDIFFtransforma cada valor deFechaPedidoantes de compararlo. SQL Server recorre el índice y la medición aumenta a 482 lecturas lógicas.
El plan explica cómo se accedió al objeto; STATISTICS IO mide parte del trabajo de lectura que produjo ese acceso. Ninguna de las dos fuentes sustituye a la otra.
Comparar consultas equivalentes
Para que la diferencia sea útil, ambas consultas deben devolver el mismo resultado y ejecutarse bajo condiciones comparables. En esta prueba las dos cuentan 136 pedidos, pero no realizan el mismo trabajo.
No existe un número universal de lecturas “correcto”. El valor depende del resultado solicitado, el volumen, los índices y la distribución de los datos. La comparación más sólida parte de la misma consulta o de dos formas equivalentes, conserva los parámetros y registra las condiciones de ejecución.
Qué podemos concluir
Podemos afirmar que transformar la columna cambió el acceso de Index Seek a Index Scan y elevó las lecturas lógicas de 4 a 482 en esta ejecución. No podemos convertir esa diferencia, por sí sola, en duración, CPU, impacto concurrente ni recomendación universal.
Siguiente comprobación razonable
La siguiente entrada incorpora SET STATISTICS TIME para separar CPU y tiempo transcurrido. Después podremos relacionar el trabajo de lectura con la duración observada sin asumir que ambas métricas significan lo mismo.