
Filter, Compute Scalar y Top
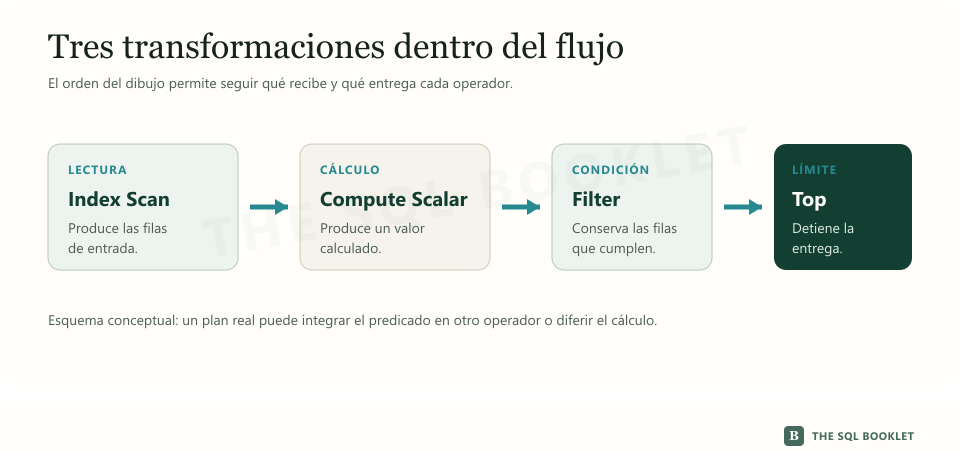
No todos los operadores buscan datos o relacionan tablas. Algunos reciben un flujo ya producido y lo transforman: descartan filas, calculan una columna o detienen la entrega cuando alcanzan un límite.
Estos operadores suelen ser pequeños dentro del dibujo, pero ayudan a reconstruir qué ocurrió entre la lectura inicial y el resultado. Su presencia describe trabajo; no demuestra por sí sola un problema.
Cómo abrir los planes de esta entrada
Activa Include Actual Execution Plan con Ctrl+M y ejecuta cada consulta por separado. Después abre Execution plan. Coloca el puntero sobre el operador que quieres revisar o selecciónalo y presiona F4; Defined Values, Predicate y las cantidades de filas aparecen en la información emergente o en Properties, según el operador.
La pestaña Results muestra las filas devueltas. La captura de cada apartado corresponde a Execution plan, no a una cuadrícula adicional producida por el SELECT.
Compute Scalar: producir un valor calculado
Compute Scalar evalúa una expresión y agrega su resultado al flujo. Una expresión combina valores, operadores y funciones para producir un valor nuevo; puede ser una multiplicación, una conversión o una condición.
Esta consulta calcula un total con impuesto para las primeras diez filas:
SELECT TOP (10)
    p.IdPedido,
    p.Total,
    p.Total * CONVERT(DECIMAL(5, 2), 1.16) AS TotalConImpuesto
FROM dbo.PedidoLaboratorio AS p
ORDER BY p.IdPedido;
El plan compilado contiene Clustered Index Scan, Compute Scalar y Top. En las propiedades de Compute Scalar, Defined Values muestra la expresión y el nombre interno del valor que produce.
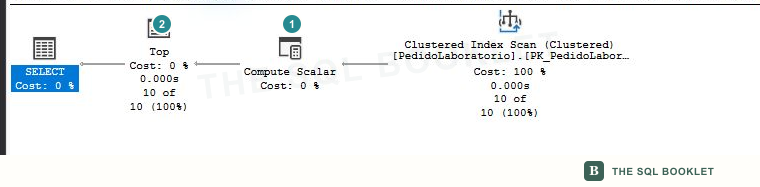
- 1Valor calculado
Compute ScalaragregaTotalConImpuestoal flujo; la expresión concreta se comprueba enDefined Values. - 2Límite de filas
Topentrega diez filas. El orden porIdPedidodetermina cuáles ocupan esas primeras posiciones.
La ubicación del icono no garantiza que todo el cálculo ocurra exactamente en ese punto. SQL Server puede diferir una expresión hasta que otro operador necesite el valor; por eso algunos planes no muestran filas ni tiempo propios para Compute Scalar. Primero comprobamos la expresión y quién consume su resultado.
Top: limitar el flujo
Top entrega una cantidad limitada de filas y deja de solicitarlas cuando alcanza ese límite. El operador puede provenir de TOP, de una paginación o de una transformación que permite establecer un límite temprano.
En la consulta anterior, ORDER BY p.IdPedido define cuáles son las primeras diez filas. Sin un orden determinista, TOP (10) limita la cantidad, pero no identifica por sí solo qué diez filas deben conservarse.
En sus propiedades conviene revisar:
Top Expression, que contiene el límite;Is Percent, que distingue una cantidad de un porcentaje;With Ties, cuando el límite conserva empates del orden indicado.
Un límite también puede influir en las alternativas consideradas por el optimizador. Eso no convierte cada Top en una mejora: debemos comprobar qué filas se pidieron y si existe un orden que las identifique.
Filter: conservar las filas que cumplen un predicado
Filter recibe filas y evalúa un predicado, una expresión cuyo resultado decide si cada fila continúa o se descarta. Un filtro escrito en WHERE no siempre produce un icono Filter: cuando es posible, la condición puede integrarse en el operador que lee los datos.
Para observarlo de forma separada, esta consulta calcula una posición y después conserva las filas 11 a 20:
SELECT
    q.IdPedido,
    q.Total,
    q.Posicion
FROM
(
    SELECT
        p.IdPedido,
        p.Total,
        ROW_NUMBER() OVER (ORDER BY p.IdPedido) AS Posicion
    FROM dbo.PedidoLaboratorio AS p
) AS q
WHERE q.Posicion BETWEEN 11 AND 20;
ROW_NUMBER produce la posición antes de que Filter pueda evaluarla. En el plan compilado aparecen Segment y Sequence Project para construir la secuencia; la siguiente entrada explica esos operadores. También aparece Top, porque el límite superior permite detener la numeración después de la fila 20.
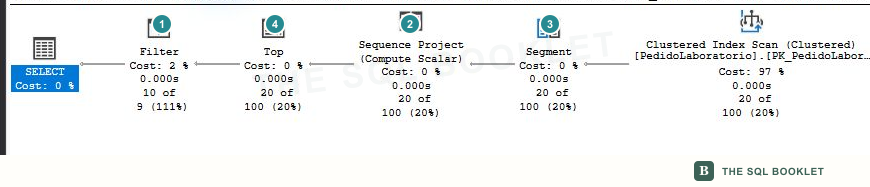
- 1Condición aplicada
Filterconserva las posiciones entre 11 y 20. La condición concreta aparece enPredicate. - 2Posición calculada
Sequence Projectagrega el valor producido porROW_NUMBER. - 3Un solo grupo
Segmentprepara la señal que utiliza la secuencia; al no existirPARTITION BY, todas las filas pertenecen al mismo grupo lógico. - 4Detención anticipada
Toppermite detener la numeración al alcanzar la posición 20; despuésFilterdescarta las primeras diez.
La propiedad Predicate de Filter muestra la condición aplicada. Para conocer su efecto comparamos las filas recibidas con las entregadas. Una diferencia grande describe selectividad en ese punto, pero todavía no explica si la lectura anterior pudo evitarse.
El mismo predicado puede aparecer en otro operador
Cuando una condición se puede evaluar durante un Index Seek, aparece como parte de Seek Predicates. Si se evalúa mientras un Scan recorre filas, puede aparecer como Predicate dentro del propio acceso. El icono Filter se reserva para los casos donde el plan necesita un operador separado.
Por eso no buscamos el icono para decidir si una consulta filtra. Seguimos la condición desde el SQL hasta la propiedad donde el plan la colocó y comparamos filas leídas, recibidas y entregadas.
Qué revisar en el plan
| Operador | Propiedad inicial | Pregunta siguiente |
|---|---|---|
Compute Scalar |
Defined Values |
¿Qué expresión produce y dónde se utiliza? |
Top |
Top Expression y orden disponible |
¿Qué filas forman el límite? |
Filter |
Predicate y filas de entrada/salida |
¿La condición pudo aplicarse durante el acceso? |
Qué conclusión todavía no permite obtener
Un Compute Scalar no es costoso solo porque calcule una expresión; Top no garantiza una lectura pequeña; y Filter no demuestra que faltó un índice. El costo depende de cuántas filas llegan, cuántas veces se ejecuta el operador y qué trabajo ocurrió antes.
La siguiente lectura debe conservar el resultado correcto y relacionar estos operadores con el orden, las estimaciones y las propiedades observadas.
Siguiente comprobación razonable
Continúa con Nested Loops, Hash Match y Merge Join para reconocer cómo dos entradas se convierten en un solo flujo.